وب اسکرپینگ قانونی است؟ مرز robots.txt، ToS و داده عمومی
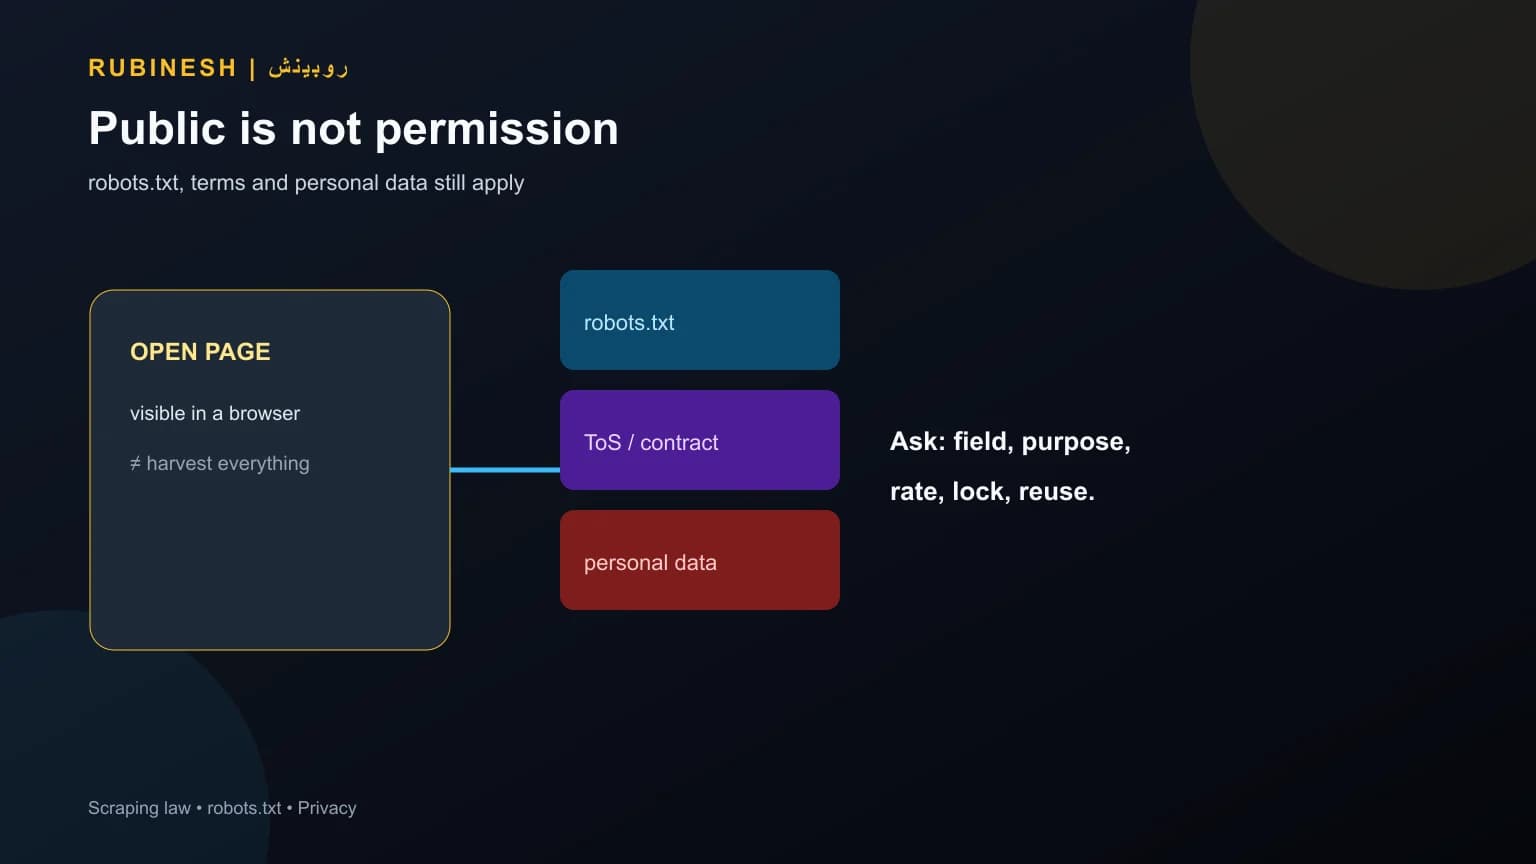
سؤال وب اسکرپینگ قانونی است جواب یککلمهای ندارد. استخراج خودکار صفحهٔ عمومی همیشه «سرقت» نیست، اما همیشه هم آزاد نیست. مرز را robots.txt، شرایط استفاده، نوع داده، فشار روی سرور، دورزدن قفل و قانون حریم خصوصی مشخص میکند. دادهٔ قیمت عمومی با پروفایل افراد یا محتوای پشت ورود یکی نیست. این مقاله مشاورهٔ حقوقی نیست؛ چارچوبی است تا قبل از سفارش استخراج، محدودهٔ مسئولانه را ببینید.
جستوجوهایی مثل «وب اسکرپینگ قانونی است»، «robots.txt چه میگوید»، «داده عمومی و شخصی»، «چه کارهایی ممنوع است» و «جایگزین مسئولانه» معمولاً از تیمی میآید که میخواهد پایش بازار یا کاتالوگ بسازد و نگران ریسک است. در این راهنما معنی robots.txt، وزن ToS، تفاوت دادهٔ شخصی و غیرشخصی، رفتارهای پرریسک و مسیر جایگزین مثل API را بررسی میکنیم. تعریف فنی استخراج در راهنمای اسکرپ دیتا و پروتکل خزیدن در مقالهٔ robots.txt آمده است. اجرای پروژههای مجاز در خدمت اسکرپ داده روبینش تعریف میشود.
A robots.txt file tells crawlers which URLs they can access; it is used mainly to manage crawl traffic, not to enforce security.
وب اسکرپینگ قانونی است؟
در بسیاری از کشورها صرف خواندن صفحهٔ در دسترس عموم، بدون ورود غیرمجاز، لزوماً جرم نیست. همزمان ممکن است قرارداد شرایط استفاده، حق مؤلف، رقابت غیرمنصفانه، دسترسی غیرمجاز به سیستم و قانون دادهٔ شخصی محدودیت ایجاد کند. «در گوگل دیده میشود» مساوی «میتوان انبوه برداشت و بازنشر کرد» نیست. نتیجه به منبع، هدف، حجم، هویت داده و روش دسترسی بستگی دارد. برای پروژهٔ جدی، بررسی حقوقی متناسب با حوزهٔ قضایی منبع و کسبوکار لازم است.
از نظر عملی، سه لایه را جدا کنید. لایهٔ فنی: آیا دسترسی بدون شکستن قفل، دورزدن ورود یا فشار مخرب ممکن است؟ لایهٔ قراردادی: آیا ToS برداشت خودکار را ممنوع کرده و شما با استفاده از سایت آن را پذیرفتهاید؟ لایهٔ داده: آیا رکورد به فرد قابل شناسایی برمیگردد؟ هر لایه پاسخ جدا میخواهد. رد شدن از captcha با نیت پنهانکاری، استفاده از حساب دیگران، یا برداشت پیام خصوصی معمولاً از محدودهٔ پروژهٔ مجاز خارج است. آگهی املاک اغلب شماره تماس دارد؛ محدودهٔ غیرشخصی را در اسکرپ آگهی املاک جدا نگه دارید.
حوزهٔ قضایی هم ساده نیست. منبع ممکن است در یک کشور باشد، سرور در کشور دوم، و کسبوکار شما در کشور سوم. قانون دسترسی غیرمجاز به سامانه، حمایت از دادهٔ شخصی و رقابت میتواند همزمان مطرح شود. پروندههای خارجی دربارهٔ دادهٔ عمومی گاهی نقل میشوند، اما نتیجهٔ یک دعوا را به پروژهٔ خودتان تعمیم ندهید؛ واقعیتهای قرارداد، روش دسترسی و نوع داده فرق دارد. اگر پروژه برای تصمیم مالی بزرگ است، قبل از ساخت اسکرپر پایدار با مشاور آشنا به همان حوزه حرف بزنید.
robots.txt چه میگوید و چه نمیگوید؟
robots.txt اعلام ترجیح مدیر سایت به رباتهاست: کدام مسیر را نخزند، کدام را آزاد بگذارند. گوگل آن را ابزار مدیریت خزش میداند نه قفل امنیتی. مسیر Disallow همچنان ممکن است در مرورگر باز شود. با این حال نادیدهگرفتن عمدی آن در استخراج انبوه، حسننیت را ضعیف میکند و در اختلاف بعدی علیه شما استفاده میشود. قبل از طراحی اسکرپر، فایل را بخوانید و مسیرهای ممنوع را از محدوده خارج کنید.
اگر Disallow گسترده است، سؤال بعدی این است آیا API، خوراک رسمی یا مجوز کتبی وجود دارد. اصرار بر خزیدن خلاف اعلام مدیر سایت، پروژه را از «جمعآوری عمومی» به «دسترسی ناخواسته» نزدیک میکند. نرخ درخواست را هم پایین نگه دارید تا سرویس مقصد مختل نشود. اختلال در دسترسبودن سایت، حتی با نیت تحلیل بازار، ریسک جدا میسازد.
| سیگنال | معنی رایج | اقدام مسئولانه |
|---|---|---|
| robots.txt Allow | ترجیح برای خزش اعلام شده | باز هم ToS و نوع داده را بسنجید |
| robots.txt Disallow | درخواست عدم خزش آن مسیر | از محدوده حذف یا مجوز بگیرید |
| ورود / paywall | دسترسی عمومی نیست | اسکرپ بدون اجازه مناسب نیست |
| API رسمی | کانال مورد انتظار تبادل | اولویت با API است |
شرایط استفاده (ToS) چه نقشی دارد؟
بسیاری از سایتها در شرایط استفاده، ربات و برداشت خودکار را محدود یا ممنوع میکنند. این متن قرارداد پیوستن است، نه مقالهٔ وبلاگ. حتی اگر از نظر کیفری «هک» محسوب نشود، نقض قرارداد میتواند به مسدودسازی، اخطار و دعوای مدنی برسد. خواندن ToS قبل از برآورد پروژه بخشی از کشف است. اگر منبع صریحاً اسکرپ را ممنوع کرده، مسیر درست درخواست مجوز یا استفاده از API است نه پنهانکردن User-Agent.
ToS را با حق مؤلف قاطی نکنید. ممکن است خواندن قیمت برای تحلیل داخلی ریسک متفاوتی با کپی شرح کالا و عکس برای فروشگاه خودتان داشته باشد. بازنشر محتوا بهعنوان محتوای شما معمولاً مسئلهٔ جدا و جدیتر است. هدف پروژه را دقیق بنویسید: پایش قیمت، تحقیق، مهاجرت با اجازه، یا تولید مجدد کاتالوگ رقبا نتایج حقوقی یکسانی ندارند.
داده عمومی با داده شخصی چه فرقی دارد؟
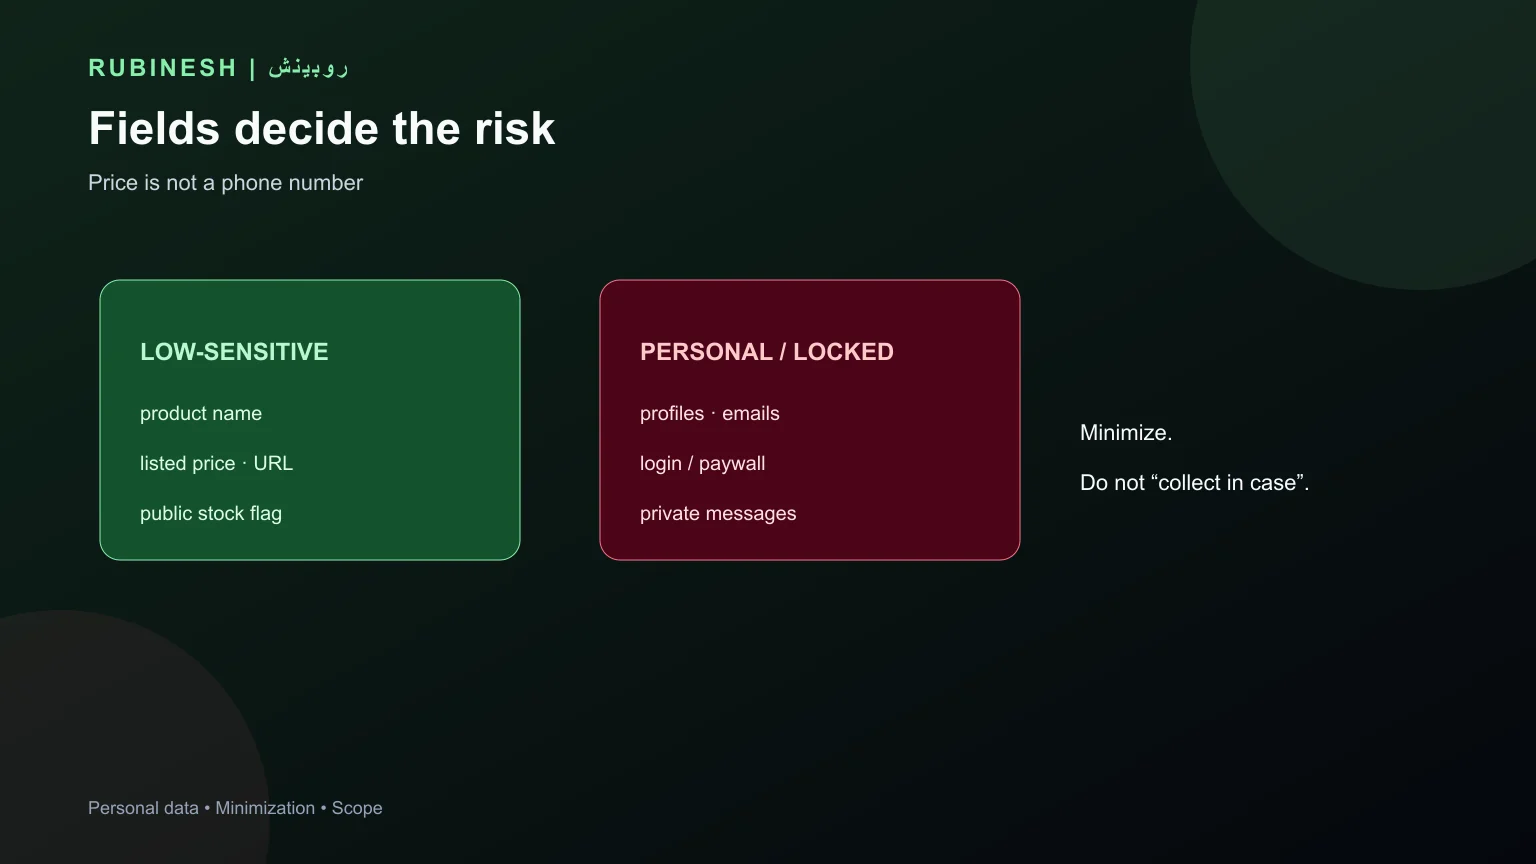
عمومی یعنی بدون ورود قابل مشاهده است، نه اینکه دیگر به فرد مربوط نباشد. نام، ایمیل، تلفن، شناسهٔ پروفایل و دادهٔ رفتاری که فرد را شناسایی میکند، در بسیاری از نظامهای حریم خصوصی «دادهٔ شخصی» است حتی اگر در صفحهٔ باز باشد. راهنماهای اروپایی دربارهٔ اسکرپ برای مدلهای مولد هم تأکید کردهاند عمومی بودن، پردازش را از شمول قواعد داده خارج نمیکند. حداقلسازی، هدف مشخص، حذف فیلدهای غیرضروری و نبردن دادهٔ حساس باید از طراحی پروژه باشد.
برای پایش بازار، فیلدهایی مثل نام کالا، قیمت نمایشی، موجودی اعلامشده و URL صفحه معمولاً کمحساستر از فهرست کاربران یا نظرات همراه مشخصات فردیاند. اگر پروژه به دادهٔ شخصی نزدیک میشود، قبل از جمعآوری مبنای قانونی، مدت نگهداری و امکان پاسخ به درخواست حذف را مشخص کنید. حدس «بعداً پاک میکنیم» معماری حریم خصوصی نیست.
نظر کاربران، عکس پروفایل، موقعیت تقریبی و شناسهٔ حساب را «دادهٔ بازاری» فرض نکنید. حتی اگر صفحه بدون ورود باز شود، ترکیب چند فیلد میتواند فرد را شناسایی کند. حداقلسازی یعنی همان ابتدا این فیلدها را نگیرید، نه اینکه بعداً در انبار داده پنهان شوند. اگر فقط قیمت لازم است، نام نویسندهٔ نظر را ذخیره نکنید. این کار هم ریسک را کم میکند و هم کیفیت تحلیل را بهتر میکند چون نویز شخصی وارد مدل قیمت نمیشود.
چه کارهایی را مسئولانه انجام ندهیم؟
- دورزدن ورود، paywall، captcha یا کنترل دسترسی
- استفاده از حساب کاربری دیگران یا اطلاعات ورود ذخیرهشده بدون مجوز
- فشار حجمی که سایت را کند یا از دسترس خارج کند
- برداشت پیام، دادهٔ مالی یا محتوای غیرعمومی
- بازنشر عکس و متن دارای حق نشر بهعنوان دارایی خود
- نادیدهگرفتن عمدی robots.txt برای پنهانکاری
- جمعآوری گستردهٔ دادهٔ کودکان یا دادهٔ حساس سلامت و رأی
- فروش پایگاه تماس افراد که از پروفایل عمومی سرهم شده
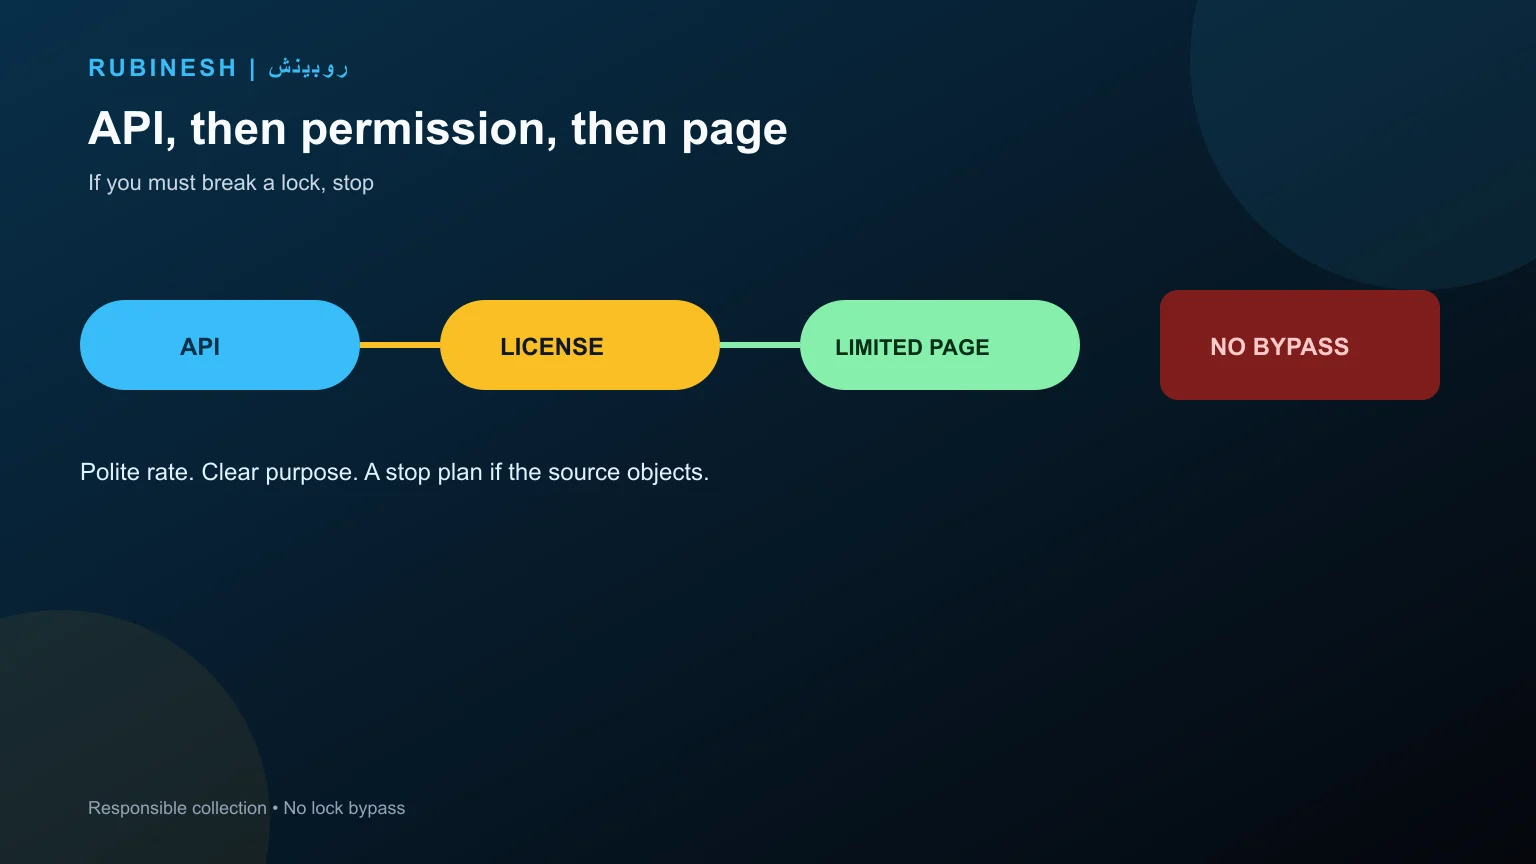
این فهرست جای قانون کامل را نمیگیرد، اما خط قرمز عملی پروژههای سالم است. اگر برای رسیدن به داده باید قفل را شکست، آن داده برای اسکرپ مجاز تعریف نشده است. درخواست رسمی، شراکت داده یا API را جایگزین تکنیک تهاجمی کنید.
جایگزین مسئولانه چیست؟
اول بپرسید آیا منبع API، فایل باز، sitemap یا برنامهٔ همکار دارد. API قرارداد مشخص، محدودیت نرخ و فیلد معین میدهد و معمولاً پایدارتر از تجزیهٔ HTML است. اینکه کی قرارداد کافی است و کی استخراج صفحه مطرح میشود در مقایسه اسکرپ با API آمده است. تعریف خودِ قرارداد را در راهنمای API ببینید. اگر API نیست، مجوز کتبی از صاحب منبع ارزش بیشتری از اسکرپر سریع دارد. برای قیمت، گاهی گزارش رسمی یا خوراک تأمینکننده دقیقتر از خزیدن ویترین است.
اگر فقط پایش چند رقیب با فیلد محدود لازم است، حجم را کم کنید، بازه را طولانیتر کنید و لاگ احترام به robots و نرخ درخواست را نگه دارید. پروژهٔ «همه چیز از همه جا» هم از نظر کیفیت داده و هم از نظر ریسک، ضعیف است. مقالهٔ مانیتورینگ قیمت رقبا همین کاربرد را با تمرکز تصمیم کسبوکار توضیح میدهد.
رفتار فنی محترمانه و کیفیت داده
حتی وقتی محدوده مجاز به نظر میرسد، روش اجرا ریسک میسازد. شناسهٔ ربات را شفاف بگذارید، زمان اوج ترافیک منبع را رعایت کنید، و اگر پاسخ خطا یا دستور توقف آمد، همانجا بایستید. تکرار تهاجمی بعد از مسدودسازی نشانهٔ حسننیت نیست. کش کردن صفحه برای کاهش درخواست بهتر از خزش مداوم همان URL است. داده را با زمان برداشت ذخیره کنید؛ قیمت بدون زمان برای تصمیم خرید بیمعنی است.
کیفیت با قانونی بودن فرق دارد ولی به هم وصلاند. HTML تغییر میکند، پس اسکرپر شکننده است و ممکن است برای «درست کار کردن» به مسیرهای پیچیدهتر و پرریسکتر کشیده شود. قرارداد با API این فشار را کم میکند. خروجی را با نمونهٔ دستی بسنجید: واحد پول، تخفیف خطخورده، موجودی صفر و صفحهٔ حذفشده. دادهٔ غلط برای قیمتگذاری از دادهٔ کم خطرناکتر است چون تصمیم را منحرف میکند.
مالکیت خروجی را هم بنویسید. استخراج قیمت برای داشبورد داخلی یک استفاده است؛ فروش همان مجموعه بهعنوان محصول داده یا ساخت فروشگاه آینهای از محتوای رقیب استفادهای دیگر است. حق نشر عکس و شرح کالا معمولاً با صفحهٔ باز بودن از بین نمیرود. اگر نیاز به نمایش عمومی دارید، منبع مجاز، مجوز یا تولید محتوای خودتان را انتخاب کنید.
چه زمانی پروژه را متوقف یا کوچک کنیم؟
اگر منبع صریحاً اعتراض کرد، اگر captcha یا ورود برای ادامه لازم شد، اگر دادهٔ شخصی بدون مبنای روشن وارد خروجی شد، یا اگر فشار درخواست روی مقصد دیده شد، اجرا را نگه دارید. ادامه دادن با تغییر IP و پنهانکاری معمولاً مشکل را بزرگتر میکند. مسیر جایگزین: مذاکره، خوراک رسمی، خرید داده از تأمینکننده، یا محدود کردن منبعها به آنهایی که کانال مشخص دارند.
برای تیم داخلی یک قانون ساده مفید است: اگر توضیح روش برای مدیر محصول و مشاور حقوقی ناراحتکننده است، آن روش وارد تولید نشود. اسکرپ مسئولانه باید قابل توضیح باشد. پنهانکاری فنی معمولاً نشانه است که محدوده از ابتدا غلط انتخاب شده، نه اینکه «فقط باید هوشمندتر خزید».
قبل از شروع پروژه چه چیزی را مکتوب کنیم؟
- هدف کسبوکار و تصمیمی که داده باید پشتیبانی کند
- فهرست منبعها و وضعیت robots.txt و ToS هر کدام
- فیلدها: کدام لازم است و کدام دادهٔ شخصی است
- روش دسترسی: API، مجوز، یا صفحهٔ عمومی
- نرخ درخواست، زمان اجرا و شناسهٔ شفاف ربات
- مدت نگهداری، دسترسی داخلی و ممنوعیت بازنشر
- مسیر توقف اگر منبع اعتراض یا مسدود کرد
این سند هم تیم فنی را محدود میکند و هم به مشاورهٔ حقوقی ورودی میدهد. بدون آن، اسکرپر «هرچه پیدا کرد» جمع میکند و ریسک بعداً کشف میشود. در روبینش پروژه با تعریف منبع مجاز و نمونه خروجی شروع میشود، نه با وعدهٔ پوشش نامحدود.
اشتباهات رایج در برداشت داده
- یکیدانستن صفحهٔ باز با اجازهٔ برداشت انبوه
- شروع خزیدن قبل از خواندن robots و ToS
- جمع فیلد شخصی «برای احتیاط» بدون هدف
- پنهانکردن ربات برای رد شدن از محدودیت
- کپی محتوا برای سایت خود بهجای تحلیل داخلی
- نبود طرح توقف و پاسخ به اعتراض منبع
چکلیست محدودهٔ مسئولانه
- هدف و فیلدهای حداقل نوشته شده است.
- robots.txt و ToS منبع بررسی شدهاند.
- دادهٔ شخصی و غیرشخصی جدا شدهاند.
- مسیر بدون دورزدن قفل و ورود تعریف شده است.
- API یا مجوز در صورت وجود اولویت دارد.
- نرخ خزش به سرویس مقصد آسیب نمیزند.
- بازنشر محتوا و فروش دادهٔ تماس افراد خارج از محدوده است.
- در صورت ابهام حقوقی، اجرا تا نظر مشاور متوقف میشود.
جمعبندی: اجازه را از صفحهٔ باز جدا کنید
وب اسکرپینگ میتواند برای دادهٔ عمومی غیرشخصی با روش محترمانه قابل دفاع باشد، اما قانونی بودن خودکار نیست. robots.txt ترجیح خزش است، ToS تعهد قراردادی میسازد، و دادهٔ شخصی حتی در صفحهٔ باز قواعد جدا دارد. شکستن قفل، فشار به سرور و بازنشر محتوای دیگران را از پروژه حذف کنید و API یا مجوز را اول ببینید.
برای بررسی امکانپذیری منبع و خروجی مجاز، اسکرپ داده روبینش و صفحه تماس نقطهٔ شروعاند. این مطلب جایگزین نظر وکیل در پروندهٔ مشخص شما نیست.
سؤالات متداول
وب اسکرپینگ قانونی است؟
همیشه بله یا خیر نیست. خواندن صفحه عمومی ممکن است مجاز باشد، اما ToS، حق نشر، دسترسی غیرمجاز و قانون داده شخصی محدودیت میسازند. برای پرونده مشخص به مشاور حقوقی نیاز است.
robots.txt الزام قانونی است؟
در بیشتر حوزهها قفل امنیتی یا قانون سخت نیست، اما ترجیح مدیر سایت برای خزش است. نادیدهگرفتن عمدی آن حسننیت را ضعیف میکند و باید در محدوده پروژه دیده شود.
داده عمومی همان داده آزاد است؟
خیر. صفحه بدون ورود میتواند داده شخصی داشته باشد. عمومی بودن نمایش، اجازه برداشت انبوه، نگهداری طولانی یا بازنشر را تضمین نمیکند.
چه کارهایی در اسکرپ ممنوع یا پرریسک است؟
دورزدن ورود و captcha، فشار مخرب به سرور، برداشت محتوای غیرعمومی، بازنشر دارای حق نشر و جمع داده شخصی بدون مبنای روشن از خط قرمزهای رایجاند.
جایگزین مسئولانه اسکرپ چیست؟
API رسمی، مجوز کتبی، خوراک تأمینکننده و در صورت لزوم برداشت محدود صفحه عمومی با نرخ محترمانه. اگر برای داده باید قفل را شکست، پروژه مناسب اسکرپ نیست.