ایندکس گوگل چیست؟ راهنمای کامل Crawl، Index و بررسی صفحات
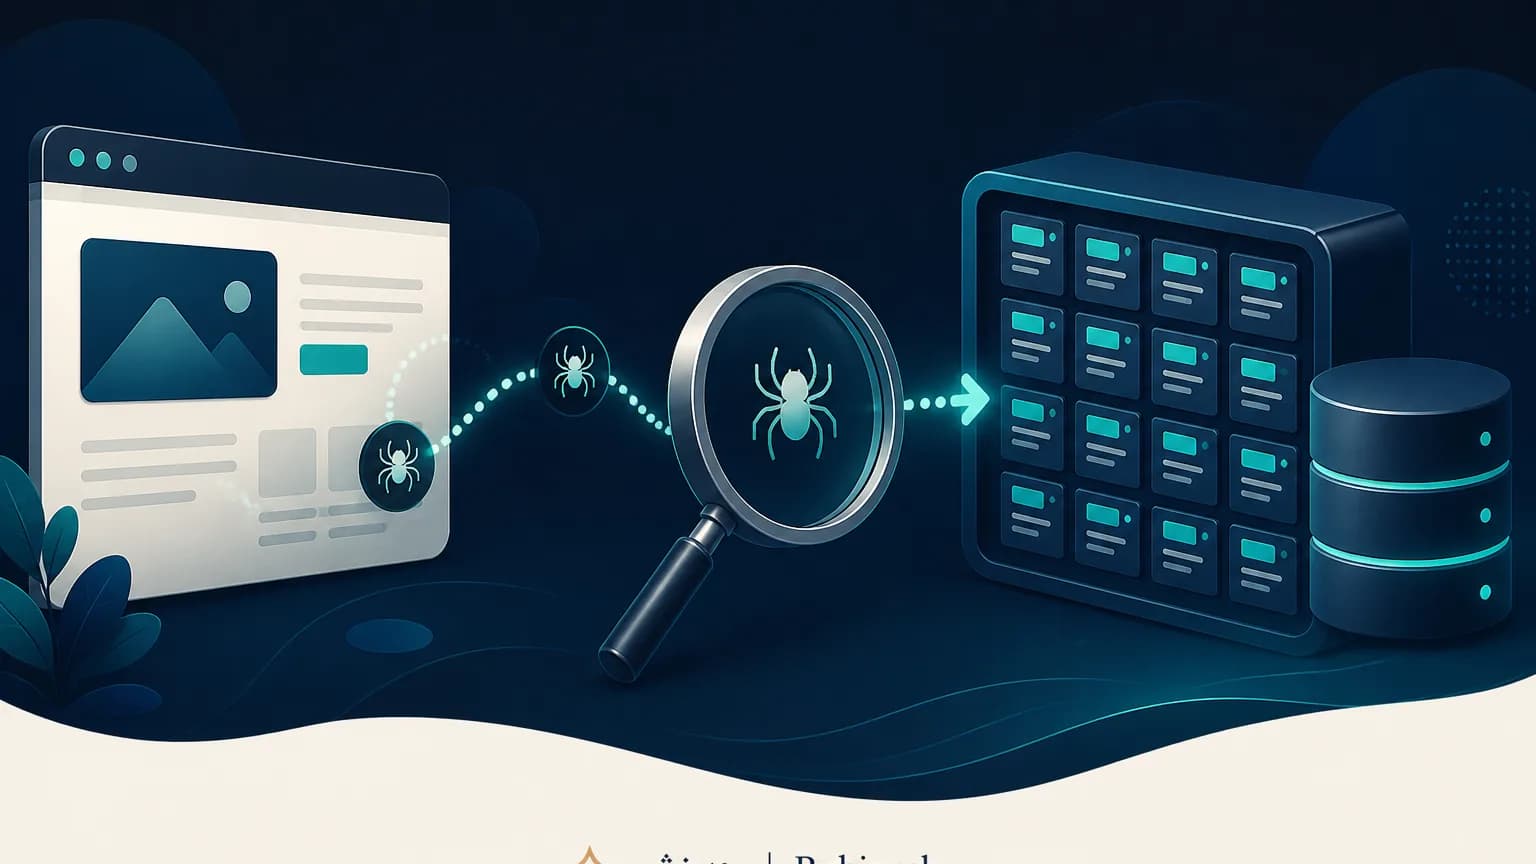
اگر میپرسید ایندکس گوگل چیست، منظور فرایندی است که در آن گوگل صفحهای را کشف، بررسی و اطلاعات قابل استفاده آن را در پایگاه داده خود ذخیره میکند تا بتواند در پاسخ به جستوجوی کاربران نمایش دهد. آنلاین بودن یک سایت بهتنهایی به معنی ایندکس شدن همه صفحات آن نیست. صفحه باید برای خزیدن قابل دسترس باشد، محتوای قابل فهم و ارزشمند داشته باشد، با دستورهایی مثل noindex مسدود نشده باشد و در معماری سایت مسیر منطقی برای کشف شدن داشته باشد.
ایندکس با رتبه گرفتن یکی نیست. ممکن است صفحهای در فهرست گوگل باشد اما برای queryهای مهم در جایگاه خوبی دیده نشود؛ برعکس، اگر صفحه اصلاً ایندکس نشده باشد، شانسی برای نمایش ارگانیک ندارد. در این راهنمای جامع، تفاوت crawl و index، مراحل کشف تا نمایش، روش بررسی با site: و Search Console، نقش sitemap و لینک داخلی، عوامل تأخیر، بودجه خزش، رندر JavaScript و چکلیست ایندکس سالم را توضیح میدهیم. برای بخش عیبیابی نیز مقاله چرا سایت در گوگل ایندکس نمیشود؟ مکمل همین راهنماست.
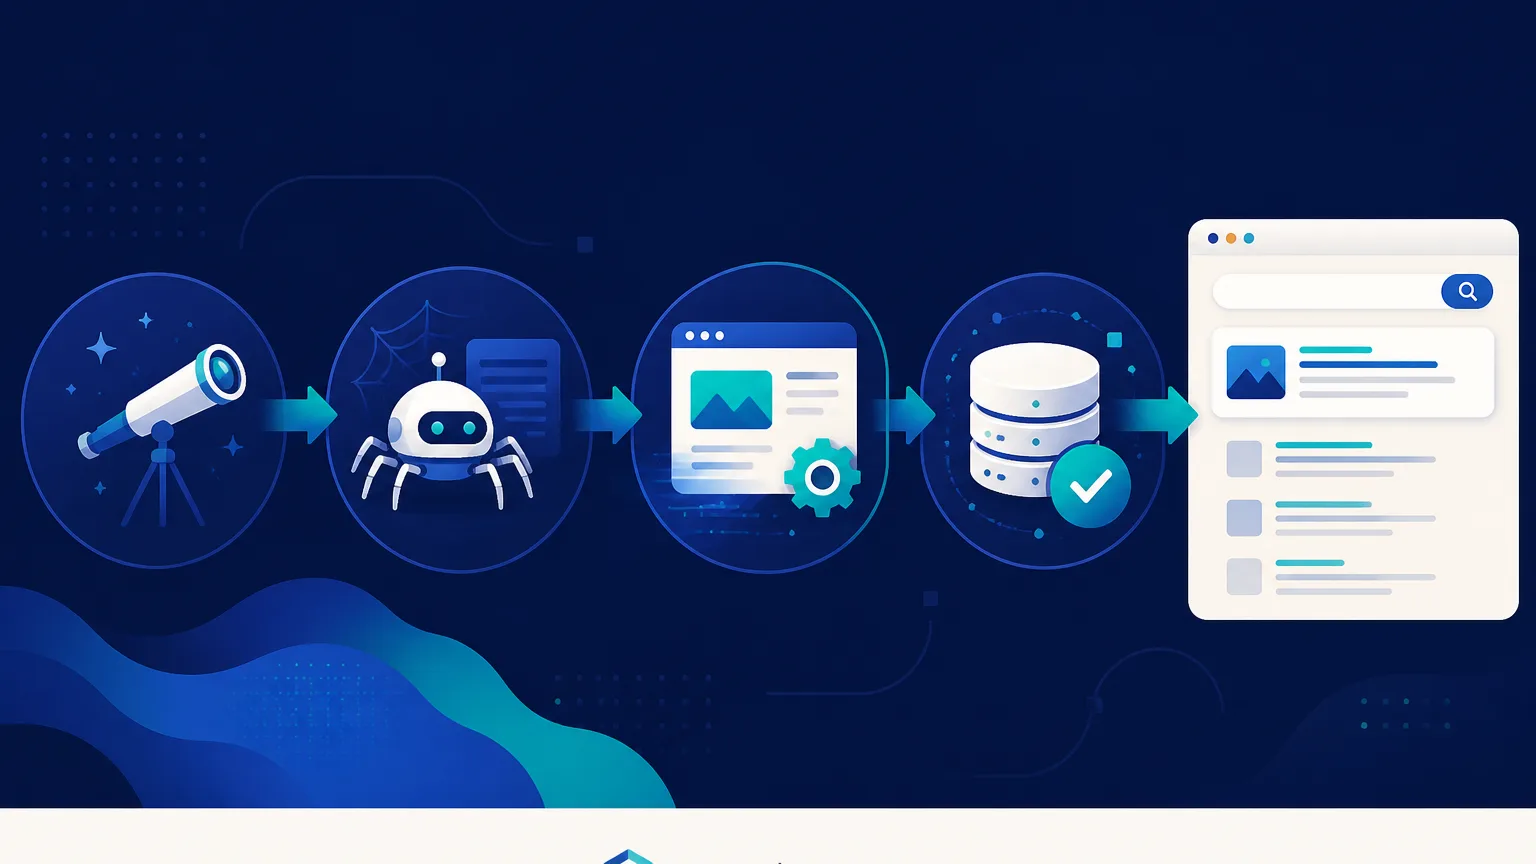
«Google Search works in three basic stages: crawling, indexing and serving search results. Not every page successfully passes through each stage.»
ایندکس گوگل چیست و چرا برای دیدهشدن ضروری است؟
ایندکس را میتوان شبیه یک فهرست بزرگ و سازمانیافته از اسناد وب دانست. گوگل هنگام پردازش صفحه، موضوع، متن، تصاویر، لینکها، دادههای ساختاریافته و سیگنالهای مختلف آن را بررسی میکند و در صورت مناسب بودن، نسخهای از اطلاعات را برای پاسخگویی سریع به جستوجوها نگه میدارد. کاربر هنگام جستوجو مستقیماً تمام وب را از ابتدا نمیگردد؛ موتور جستوجو از دادههای پردازششده خود، نتایج مرتبط را انتخاب میکند.
ایندکس شدن به معنی تأیید کیفیت یا تضمین رتبه نیست. صفحه میتواند ایندکس شود اما بهدلیل رقابت، ناهماهنگی با intent، محتوای کمعمق، تجربه ضعیف یا اعتبار پایین، در نتایج قابل توجهی دیده نشود. بنابراین گزارش «صفحه در گوگل هست» فقط یک مرحله را تأیید میکند؛ بعد از آن باید ارتباط صفحه با query و عملکرد آن را در Search Console تحلیل کرد.
تفاوت Crawl، Index و Ranking چیست؟
Crawling یا خزیدن یعنی Googlebot URLها را پیدا و درخواست میکند تا محتوای آنها را ببیند. Indexing یعنی گوگل محتوای پردازششده را برای استفاده در جستوجو ذخیره و سازماندهی میکند. Ranking مرحلهای است که برای یک query مشخص، سیستم گوگل از میان صفحات موجود، نتایج را مرتب میکند. این سه مرحله به هم مربوطاند اما جای هم را نمیگیرند.
| مرحله | پرسش اصلی | مشکل رایج | ابزار بررسی |
|---|---|---|---|
| خزیدن | آیا گوگل میتواند URL را پیدا و درخواست کند؟ | robots، خطای سرور، نبود لینک | لاگ، URL Inspection، تست دسترسی |
| ایندکس | آیا محتوای صفحه برای فهرست گوگل پذیرفته شده است؟ | noindex، canonical، محتوای تکراری | Search Console، source HTML |
| رتبهبندی | برای query مناسب در چه جایگاهی دیده میشود؟ | رقابت، intent، کیفیت و اعتبار | Performance، تحلیل SERP |
گوگل صفحه جدید را چگونه کشف میکند؟
کشف URL از چند مسیر اتفاق میافتد: لینک داخلی، لینک خارجی، sitemap، redirect، فهرستهای قبلی و گاهی منابعی که خود گوگل از وب میشناسد. انتشار یک صفحه بدون لینک داخلی مانند قرار دادن کتابی در اتاقی بدون در است؛ ممکن است آدرس آن از راه دیگری پیدا شود، اما معماری قابل اتکا نیست. برای همین در طراحی سایت، صفحه مهم باید از یک مسیر منطقی و قابل دنبالکردن به صفحات دیگر وصل باشد.
نقشه سایت XML فهرستی از URLهای مهم است و به کشف کمک میکند، اما تضمین نمیکند همه URLها ایندکس شوند. sitemap جای محتوای خوب، لینک داخلی یا رفع خطای فنی را نمیگیرد. URLهای پارامتری، صفحات فیلتر بیارزش، نسخههای تکراری و صفحههای noindex را بدون سیاست مشخص وارد نقشه سایت نکنید؛ نقشهای که پر از سیگنالهای متناقض است، بررسی وضعیت واقعی را سخت میکند.
Googlebot برای خزیدن به چه چیزهایی نیاز دارد؟
صفحه باید از نظر شبکه و سرور قابل دسترس باشد و پاسخ مناسبی بدهد. خطاهای مکرر 5xx، timeout، زنجیره طولانی redirect یا پاسخ متفاوت و ناپایدار برای خزنده میتواند پردازش را به تعویق بیندازد. HTTPS معتبر، DNS سالم و نبود محدودیت ناخواسته فایروال نیز بخشی از پایه فنی هستند. اگر سایت پشت CDN یا ابزار امنیتی قرار دارد، مطمئن شوید Googlebot واقعی و درخواستهای مشروع مسدود نمیشوند.
فایل robots.txt برای مدیریت crawl است، نه ابزاری برای حذف قطعی URL از ایندکس. اگر صفحهای قبلاً شناخته شده باشد و بعد با robots مسدود شود، گوگل ممکن است هنوز URL آن را بداند اما نتواند محتوای صفحه و تگ noindex را ببیند. برای جلوگیری از ایندکس، سیاست مناسب باید با دسترسی خزنده و header یا meta robots هماهنگ شود. هر تغییر robots را در محیط production با تست و version control منتشر کنید.
گوگل هنگام پردازش صفحه چه چیزهایی را بررسی میکند؟
گوگل فقط متن خام صفحه را نمیبیند. ساختار HTML، عنوان، headingها، متن اصلی، لینکها، تصاویر، canonical، زبان، داده ساختاریافته و وضعیت پاسخ را کنار هم بررسی میکند. در صفحات JavaScript، رندر نیز اهمیت دارد؛ اگر متن و لینکهای اصلی فقط بعد از اجرای اسکریپت و در شرایطی خاص ظاهر شوند، فهم و کشف آنها دشوارتر میشود. SSR یا خروجی HTML اولیه قابل اتکا، معمولاً مسیر پایدارتری برای محتوای مهم است.
پردازش ممکن است بهدلیل محتوای بسیار مشابه، کیفیت پایین، canonical متفاوت، نبود ارزش مستقل یا سیگنالهای متناقض به ایندکس نشدن صفحه منجر شود. حذف یا ادغام صفحات کمارزش گاهی از تلاش برای ایندکس تکتک URLها نتیجه بهتری دارد. راهنمای زامبی پیج و پاکسازی صفحات مرده برای تشخیص این بخش مفید است.
چطور بفهمیم صفحه در گوگل ایندکس شده است؟
سریعترین بررسی عمومی، جستوجوی site: است؛ برای مثال site:example.com/page. این روش برای یک نگاه اولیه مفید است اما همه وضعیتهای Search Console را نشان نمیدهد و نبود نتیجه همیشه توضیح دقیقی درباره علت ارائه نمیکند. در Search Console، ابزار URL Inspection را باز کنید و URL دقیق را وارد کنید. گزارش باید وضعیت ایندکس، canonical انتخابشده، آخرین crawl و امکان درخواست بررسی را روشن کند.
site:example.com/blog/example-pageبرای یک سایت، گزارش Pages تصویر گستردهتری از URLهای ایندکسنشده میدهد. دستههایی مانند «Crawled - currently not indexed»، «Discovered - currently not indexed»، «Excluded by noindex» یا «Duplicate, Google chose different canonical» علتهای متفاوتی دارند و نباید با یک نسخه ثابت درمان شوند. هر گروه را جدا تحلیل کنید و بعد از اصلاح، چند URL نماینده را در URL Inspection دوباره بررسی کنید.
آیا Request Indexing ایندکس را فوری انجام میدهد؟
دکمه Request Indexing درخواست بررسی مجدد URL را ثبت میکند، نه اینکه صفحه را بهزور وارد ایندکس کند. گوگل پس از دریافت درخواست، دسترسی، کیفیت و سیگنالهای صفحه را بررسی میکند و زمان انجام آن ثابت نیست. استفاده مکرر برای صدها URL، جای sitemap و معماری درست را نمیگیرد. این قابلیت را برای صفحه جدید یا صفحهای که اصلاح مهمی داشته، بهصورت محدود و هدفمند استفاده کنید.
قبل از درخواست، ابتدا علت را رفع کنید. اگر noindex باقی مانده، canonical به صفحه دیگری اشاره میکند، صفحه لینک داخلی ندارد یا سرور خطا میدهد، درخواست مکرر فقط همان مشکل را دوباره به گوگل نشان میدهد. بعد از اصلاح، source HTML، headerها و URL Inspection را بررسی و سپس درخواست را ارسال کنید.
نقش Sitemap در ایندکس سایت چیست؟
نقشه سایت XML به گوگل میگوید کدام URLها برای کشف و بررسی مهم هستند و اطلاعاتی مانند lastmod میتواند در فهم تغییرات کمک کند. sitemap باید تمیز، قابل دسترس و همراستا با canonical باشد. URLهای 404، redirect، noindex، نسخههای پارامتری بیارزش و صفحات غیرقابل دسترسی را وارد آن نکنید.
در Search Console، sitemap را ثبت و خطاهای پردازش آن را بررسی کنید. اگر sitemap هزار URL دارد اما فقط ده URL واقعاً صفحه اصلی و قابل ایندکس هستند، مشکل تعداد نیست؛ مشکل کیفیت ورودیهاست. برای ساختار پروژه، مقاله راهنمای نقشه سایت XML را ببینید و تغییرات مهم را با انتشار نسخه جدید سایت هماهنگ کنید.
چرا لینک داخلی برای ایندکس مهم است؟
لینک داخلی دو نقش دارد: به گوگل مسیر کشف URL را نشان میدهد و رابطه موضوعی صفحات را توضیح میدهد. صفحهای که فقط در sitemap آمده اما هیچ صفحه مرتبطی به آن لینک نداده، از نظر معماری ضعیفتر از صفحهای است که از یک مقاله پربازدید، صفحه مادر و دسته مرتبط لینک میگیرد. anchor باید مقصد را صادقانه توصیف کند و در متن طبیعی قرار بگیرد.
برای هر صفحه مهم، حداقل یک مسیر ورودی از صفحهای مرتبط داشته باشید. از صفحه پیلار به clusterها و از cluster به صفحه خدمت یا پیلار لینک دهید. لینکسازی داخلی را با تکرار exact-match در همه صفحات اشتباه نگیرید؛ عبارتهای توصیفی مثل «راهنمای عملی بررسی URL» یا «آموزش ساخت نقشه سایت» برای کاربر و موتور جستوجو طبیعیتر هستند. اگر میخواهید این ساختار را عمیقتر بررسی کنید، اصول لینکسازی داخلی و انکر تکست را بخوانید.
تأثیر noindex و canonical بر ایندکس
تگ noindex به موتور جستوجو میگوید صفحه نباید در نتایج ایندکس شود. canonical سیگنالی است برای معرفی نسخه ترجیحی میان URLهای مشابه یا تکراری. این دو را یکی ندانید: canonical بهتنهایی دستور حذف نیست و noindex نیز جای canonical صحیح را در خانواده URLهای مشابه نمیگیرد. اگر صفحهای canonical خودارجاع ندارد و به صفحه دیگری اشاره میکند، انتظار ایندکس مستقل آن منطقی نیست.
پارامترهای tracking، اسلش انتهایی، نسخه http و https، www و non-www یا فیلترها میتوانند URLهای متعدد بسازند. سیاست URL، redirect و canonical را یکپارچه کنید. برای جزئیات، راهنمای تگ کنونیکال و آموزش ریدایرکت 301 را در کنار گزارش canonical انتخابشده در Search Console بررسی کنید.
آیا محتوای کمکیفیت مانع ایندکس میشود؟
ایندکس یک رأی مثبت قطعی به کیفیت نیست، اما گوگل منابع پردازش و فضای نتایج را برای همه نسخههای مشابه به یک شکل مصرف نمیکند. صفحهای با چند جمله عمومی، ترجمه ماشینی بدون ارزش افزوده، متن تکراری یا محتوایی که پاسخ intent را نمیدهد ممکن است ایندکس نشود یا پس از مدتی از نتایج کمرنگ شود. پیش از درخواست ایندکس، بپرسید این صفحه چه سؤال مشخصی را بهتر از صفحات موجود پاسخ میدهد.
عنوان و description باید با محتوای صفحه هماهنگ باشند، اما metadata جذاب نمیتواند متن ضعیف را نجات دهد. تجربه نویسنده، نمونه واقعی، داده قابل بررسی، ساختار قابل خواندن، لینک به منابع معتبر و پاسخ روشن، ارزش مستقل صفحه را بالا میبرد. تولید محتوای سئو را با هدف حل مسئله و معماری خوشهای انجام دهید، نه فقط برای افزودن URL به sitemap.
رندر JavaScript چه اثری روی ایندکس دارد؟
اگر صفحه با Next.js، React یا یک اپلیکیشن client-heavy ساخته شده، باید خروجی واقعی production را بررسی کنید. گوگل میتواند JavaScript را اجرا کند، اما این مرحله همیشه همزمان با crawl نیست و اجرای اسکریپت هزینه و پیچیدگی دارد. متن اصلی، title، canonical، لینکهای مهم و دادههای پایه بهتر است در HTML اولیه قابل مشاهده باشند. hydration نباید باعث شود محتوای مهم فقط برای کاربر واردشده یا بعد از تعامل ظاهر شود.
برای بررسی، View Source، URL Inspection و ابزارهای رندر را کنار هم بگذارید. صفحهای که در مرورگر توسعهدهنده عالی دیده میشود ممکن است در source اولیه محتوای کمی داشته باشد. استفاده درست از SSR، metadata API، لینکهای واقعی HTML و مدیریت خطاهای runtime، مسیر خزش و پردازش را پایدارتر میکند. مقاله ارتباط طراحی سایت و سئو این موضوع را از زاویه معماری محصول نیز توضیح میدهد.
Crawl Budget برای چه سایتهایی مهمتر است؟
بودجه خزش یعنی میزان توجه و درخواستهایی که خزنده در یک بازه به سایت اختصاص میدهد. برای سایت کوچک با چند ده صفحه، معمولاً وسواس درباره crawl budget اولویت نیست. در سایتهای بزرگ، فروشگاهی یا سایتهایی با پارامترها، صفحات تکراری، خطاهای سرور و فیلترهای بیپایان، مدیریت crawl اهمیت بیشتری دارد. کمکردن URLهای کمارزش و هدایت خزنده به صفحات مهم معمولاً از افزایش مصنوعی لینک یا درخواستهای تکراری مؤثرتر است.
صفحات 404، redirect chain، queryهای بیپایان، تقویمهای خودکار و session URLها را شناسایی کنید. robots را بدون تحلیل کورکورانه نبندید؛ ابتدا بفهمید کدام URLها واقعاً منابع را مصرف میکنند. لاگ سرور میتواند نشان دهد Googlebot بیشتر به کدام مسیرها میرود و آیا با خطا یا پاسخ کند روبهرو میشود. برای ممیزی ترکیبی، چکلیست ممیزی سئو تکنیکال کاربردی است.
چکلیست ایندکس برای هر صفحه جدید
- URL کوتاه، پایدار و مربوط به یک intent مشخص است.
- صفحه از یک یا چند صفحه مرتبط لینک داخلی واقعی دارد.
- پاسخ سرور 200 است و زنجیره redirect غیرضروری ندارد.
- robots.txt بهاشتباه مسیر را مسدود نمیکند.
- meta robots یا header، noindex ناخواسته ندارد.
- canonical به نسخه درست و ترجیحاً خود صفحه اشاره میکند.
- title، H1، description و محتوای قابل مشاهده همموضوعاند.
- صفحه در sitemap مناسب قرار گرفته و URLهای بیارزش وارد نقشه نشدهاند.
- محتوا ارزش مستقل و پاسخ واقعی برای جستوجو دارد.
- HTML اولیه، لینکها و متن اصلی حتی بدون تعامل پیچیده قابل فهماند.
- در URL Inspection و گزارش Pages وضعیت صفحه بررسی شده است.
- بعد از اصلاح، درخواست بررسی مجدد فقط یکبار و هدفمند ارسال شده است.
جمعبندی: ایندکس نتیجه معماری، دسترسی و ارزش است
ایندکس گوگل مرحلهای میان کشف صفحه و نمایش آن در نتایج است. برای ایندکس سالم، سایت باید قابل خزیدن، از نظر فنی پایدار، از نظر محتوا ارزشمند و از نظر معماری قابل دنبالکردن باشد. sitemap و Request Indexing مفیدند، اما جای لینک داخلی، canonical صحیح، رفع noindex و محتوای مستقل را نمیگیرند.
وضعیت را با یک ابزار نسنجید: site search برای نگاه سریع، Search Console برای تشخیص، source و header برای بررسی فنی، و Analytics برای فهم ارزش تجاری صفحه کاربرد دارند. اگر صفحهای ایندکس نمیشود، قبل از درخواست دوباره علت را طبقهبندی کنید و سپس اصلاح را با داده پیگیری کنید. برای عیبیابی مرحلهای میتوانید به راهنمای رفع ایندکس نشدن سایت و خدمات سئو و تولید محتوای روبینش مراجعه کنید.
سؤالات متداول
ایندکس گوگل چیست؟
ایندکس فرایندی است که گوگل اطلاعات پردازششده صفحات وب را در پایگاه داده خود ذخیره و سازماندهی میکند تا بتواند آنها را در پاسخ به جستوجو نمایش دهد.
تفاوت Crawl و Index چیست؟
Crawl یعنی Googlebot URL و محتوای آن را پیدا و درخواست میکند؛ Index یعنی اطلاعات صفحه برای استفاده در جستوجو ذخیره میشود. Ranking مرحله جداگانه مرتبسازی نتایج است.
چطور بفهمیم یک صفحه ایندکس شده است؟
برای بررسی سریع از جستوجوی site: استفاده کنید و برای گزارش دقیقتر URL را در URL Inspection سرچ کنسول وارد کنید. گزارش Pages نیز وضعیت گروهی URLها را نشان میدهد.
آیا sitemap ایندکس شدن را تضمین میکند؟
خیر، sitemap به کشف URLهای مهم کمک میکند اما جای محتوای ارزشمند، لینک داخلی، canonical صحیح و دسترسی مناسب خزنده را نمیگیرد.
آیا ایندکس شدن یعنی صفحه رتبه خوبی دارد؟
خیر، ایندکس فقط به معنی حضور صفحه در فهرست گوگل است. رتبه به intent، کیفیت، رقابت، اعتبار، تجربه کاربر و سیگنالهای دیگر وابسته است.