چرا سایت در گوگل ایندکس نمیشود؟ ۱۰ دلیل و راهحل عملی
اگر صفحه یا مقالهتان در گوگل دیده نمیشود، اولین سؤال این نیست که «چطور رتبه را بالا ببریم؟»؛ باید بپرسید چرا سایت در گوگل ایندکس نمیشود. صفحهای که در فهرست گوگل نیست، با افزایش کلمه کلیدی یا خرید لینک رتبه نمیگیرد. علت میتواند از یک noindex ساده و robots.txt اشتباه تا canonical نادرست، نبود لینک داخلی، خطای سرور، محتوای تکراری یا مشکل رندر JavaScript باشد.
عبارتهایی مثل «ایندکس نشدن سایت در گوگل»، «چرا سایتم در گوگل نیست؟» و «چگونه صفحه را در سرچ کنسول ایندکس کنیم؟» معمولاً یک پاسخ سطحی میگیرند: URL را در Search Console وارد کنید و Request Indexing بزنید. این کار فقط وقتی مفید است که علت اصلی قبلاً رفع شده باشد. در این راهنمای عملی، تشخیص را از سطح دامنه تا URL، از دسترسی خزنده تا کیفیت محتوا، مرحلهبهمرحله پیش میبریم و برای هر سناریو اقدام مناسب را مشخص میکنیم.
«A page needs to be accessible to Googlebot, have content that can be indexed, and meet Google’s quality requirements to be eligible for indexing.»
اول بفهمید مشکل کل سایت است یا یک URL
قبل از تغییر کد، دامنه مشکل را مشخص کنید. اگر صفحه اصلی، چند مقاله قدیمی و صفحات خدمات در گوگل هستند اما یک URL جدید نیست، احتمالاً مسئله به همان صفحه یا دسته آن مربوط است. اگر هیچ صفحهای ایندکس نشده، باید مالکیت Search Console، وضعیت دامنه، robots، noindex، DNS، سرور و انتشار production را بررسی کنید. درمان این دو سناریو کاملاً متفاوت است.
در گوگل میتوانید برای بررسی سریع از عبارت site:example.com استفاده کنید، اما این روش گزارش کامل نیست. URL Inspection در Search Console برای یک صفحه دقیقتر است و گزارش Pages برای دیدن الگوی خطا در مقیاس سایت کاربرد دارد. تاریخ انتشار صفحه، آخرین تغییر، آخرین crawl و وضعیت واقعی HTML را نیز ثبت کنید تا تصمیم شما بر اساس حدس نباشد.
site:example.com
site:example.com/blog/example-page
گزارش URL Inspection را چگونه بخوانیم؟
URL را دقیقاً با همان protocol، hostname، اسلش و مسیر وارد کنید. Search Console ممکن است بین نسخه www و non-www یا http و https تفاوت قائل شود. به چند بخش مهم دقت کنید: آیا URL در Google است؟ آخرین crawl چه زمانی بوده؟ canonical اعلامشده صفحه چیست؟ canonical انتخابشده گوگل کدام است؟ آیا ایندکسپذیری صفحه مجاز است؟ هر پیام را با source و پاسخ سرور مقایسه کنید.
«URL is not on Google» علت واحدی ندارد. ممکن است صفحه تازه باشد و هنوز crawl نشده باشد، در صف کشف باشد، توسط noindex کنار گذاشته شده باشد، duplicate تشخیص داده شود یا کیفیت کافی برای ایندکس مستقل نداشته باشد. دکمه Request Indexing تنها پس از فهم دلیل استفاده شود. درخواست تکراری برای صفحهای که noindex دارد، خطا را حل نمیکند.
دلیل اول: تگ noindex ناخواسته
تگ noindex یکی از رایجترین علتهای ایندکس نشدن صفحه است. ممکن است در HTML بهصورت meta robots آمده باشد یا از طریق header X-Robots-Tag ارسال شود. در وردپرس، گزینه «از موتورهای جستوجو درخواست کن محتوای سایت را بررسی نکنند» یا تنظیمات افزونه سئو میتواند در محیط توسعه فعال بماند. در Next.js نیز metadata یا middleware ممکن است robots را برای مسیر اشتباه تنظیم کند.
<meta name="robots" content="noindex, follow">در View Source و response header هر دو را بررسی کنید. حذف noindex از یک template کافی نیست اگر header سرور هنوز آن را ارسال میکند. اگر صفحه واقعاً خصوصی، آزمایشی یا کمارزش است، noindex ممکن است تصمیم درست باشد؛ هدف این ممیزی حذف همه دستورهای محدودکننده نیست، بلکه تشخیص ناخواسته بودن آنهاست.
دلیل دوم: مسدود شدن URL با robots.txt
robots.txt به خزنده میگوید به کدام مسیرها درخواست ندهد. یک دستور اشتباه مثل Disallow: / میتواند کل سایت را از دسترس Googlebot خارج کند. مسدود کردن مسیر CSS، JavaScript یا تصاویر نیز ممکن است رندر و فهم صفحه را ضعیف کند. از طرف دیگر، robots.txt برای حذف URLی که قبلاً شناخته شده مناسب نیست؛ چون خزنده ممکن است نتواند noindex یا محتوای اصلاحشده را ببیند.
فایل را در /robots.txt دامنه اصلی باز کنید و user-agentهای مختلف، Disallowها، Allowها و آدرس sitemap را بررسی کنید. بعد از تغییر، مطمئن شوید نسخه production همان فایل مورد انتظار را برمیگرداند. راهنمای دستورات و تست robots.txt برای تحلیل دقیقتر مسیرهای مجاز و ممنوع مناسب است.
دلیل سوم: canonical به URL دیگری اشاره میکند
اگر صفحه A در head خود canonical صفحه B را اعلام کند، گوگل ممکن است صفحه B را نسخه اصلی بداند و A را مستقل ایندکس نکند. این وضعیت در صفحات فیلتر، پارامترهای tracking، نسخه چاپی، مهاجرت دامنه یا templateهای اشتباه زیاد دیده میشود. canonical یک hint است، نه تضمین؛ اما وقتی با redirect، sitemap و لینکهای داخلی همجهت باشد، سیگنال قویتری میسازد.
canonical اعلامشده را با canonical انتخابشده گوگل مقایسه کنید. اگر صفحه باید مستقل باشد، canonical آن را به خودش برگردانید و لینکهای داخلی و sitemap را نیز اصلاح کنید. اگر دو صفحه واقعاً یک محتوا و intent دارند، بهجای اصرار برای ایندکس هر دو، ادغام یا redirect 301 منطقیتر است. مقاله تگ کنونیکال چیست؟ و راهنمای ریدایرکت 301 در این تصمیم کمک میکنند.
دلیل چهارم: Discovered یا Crawled - currently not indexed
وضعیت «Discovered - currently not indexed» یعنی گوگل URL را میشناسد اما هنوز آن را crawl نکرده است. علت میتواند تازگی صفحه، تعداد زیاد URLهای کمارزش، سیگنال ضعیف یا محدودیت موقت منابع باشد. «Crawled - currently not indexed» یعنی گوگل صفحه را دیده اما فعلاً آن را برای ایندکس مستقل انتخاب نکرده است. این پیامها با noindex یکی نیستند و نباید همان درمان را روی آنها اجرا کرد.
برای Discovered، لینک داخلی از صفحات مرتبط، sitemap تمیز، پاسخ سریع و کاهش URLهای کمارزش را بررسی کنید. برای Crawled، کیفیت، تکراری نبودن، تفاوت واقعی با صفحات مشابه و تطابق intent را اولویت دهید. افزودن متن بیربط یا تکرار کلمه کلیدی درمان نیست. صفحه باید دلیل روشن و قابل مشاهدهای برای وجود مستقل داشته باشد.
دلیل پنجم: صفحه هیچ لینک داخلی ندارد
صفحه یتیم ممکن است در sitemap باشد، اما از بدنه سایت مسیر طبیعی برای کشف نداشته باشد. نبود لینک داخلی هم کشف را سختتر میکند و هم باعث میشود گوگل رابطه موضوعی و اهمیت صفحه را کمتر بفهمد. برای مقاله جدید، از یک مقاله مرتبط قدیمی، صفحه پیلار و در صورت ارتباط از خدمت مادر لینک بدهید. لینک باید در متن قابل مشاهده، با anchor دقیق و بدون تکرار مصنوعی قرار گیرد.
اگر صفحه یتیم ارزش ندارد، حذف یا ادغام را بررسی کنید؛ برای هر URL صرفاً یک لینک تصادفی نسازید. اگر ارزش دارد، آن را در معماری اطلاعات جای دهید: مقاله راهنما به مقاله جزئیتر وصل شود، مقاله جزئیتر به صفحه خدمت یا پیلار برگردد و مسیر کاربر روشن باشد. ممیزی لینک داخلی فقط شمارش لینک نیست؛ مقصد، anchor، ارتباط و مسیر تبدیل هم باید کنترل شوند.
دلیل ششم: محتوای تکراری یا شباهت زیاد
دو URL ممکن است متن بسیار مشابه، هدف یکسان یا نسخههای متفاوت یک محصول داشته باشند. گوگل گاهی یکی را بهعنوان canonical انتخاب میکند و دیگری را کنار میگذارد. کپیکردن یک مقاله برای چند شهر، تغییر چند کلمه در صفحات خدمت یا ساخت فیلترهای بیمحتوا نمونههای رایجاند. تعداد URL بیشتر الزاماً به معنی پوشش بیشتر نیست.
محتوای صفحات نزدیک را کنار هم بگذارید و بپرسید آیا تفاوتی واقعی برای کاربر وجود دارد. اگر دارد، تفاوت را در داده، مثال، خدمت، منطقه یا نیاز جستوجو آشکار کنید. اگر ندارد، ادغام، redirect یا canonical منطقیتر است. صفحات زامبی و آرشیوهای کمارزش را در کنار گزارش Pages و لینکهای داخلی بررسی کنید؛ برای این کار راهنمای زامبی پیج مفید است.
دلیل هفتم: خطای سرور، timeout یا redirect chain
اگر Googlebot هنگام درخواست صفحه پاسخ 5xx، timeout یا loop ریدایرکت دریافت کند، محتوای قابل پردازشی ندارد. گاهی مرورگر شما صفحه را باز میکند اما crawler در زمان دیگری با خطا مواجه میشود. لاگ سرور، uptime، CDN و ابزارهای مانیتورینگ را در زمان crawl بررسی کنید. redirect chain طولانی، مقصد نهایی نامرتبط یا تفاوت بین نسخه موبایل و دسکتاپ نیز باید اصلاح شوند.
صفحه باید در حالت عادی پاسخ 200 بدهد و محتوای اصلی را تحویل دهد. اگر URL برای همیشه منتقل شده، یک redirect 301 مستقیم به مقصد مناسب بگذارید؛ اگر موقتاً در دسترس نیست، کد وضعیت را با سناریو هماهنگ کنید. ریدایرکت همه URLهای حذفشده به homepage، هم برای کاربر گمراهکننده است و هم میتواند soft 404 بسازد. وضعیت 404 واقعی و مدیریت آن را در راهنمای خطای 404 ببینید.
دلیل هشتم: محتوای مهم فقط بعد از JavaScript ظاهر میشود
در سایتهای React و Next.js، صفحه ممکن است در مرورگر کامل دیده شود اما HTML اولیه title، متن یا لینکهای مهم را نداشته باشد. گوگل میتواند JavaScript را اجرا کند، اما مرحله رندر جدا از crawl است و خطاهای runtime، وابستگی به API یا نمایش مشروط میتواند محتوا را پنهان کند. برای صفحات مهم، SSR یا HTML اولیه قابل خواندن، مسیر مطمئنتری است.
View Source را باز کنید و ببینید H1، متن اصلی، canonical، meta robots و لینکهای کلیدی واقعاً در خروجی production هستند. Console error، response API و رفتار صفحه در حالت کند را نیز بررسی کنید. metadata که فقط بعد از hydration اضافه میشود، راهکار مناسبی برای سیگنال اصلی صفحه نیست. اصول ارتباط طراحی و سئو در این راهنما توضیح داده شده است.
دلیل نهم: صفحه ارزش مستقل کافی ندارد
گاهی هیچ خطای فنی واضحی ندارید اما صفحه همچنان ایندکس نمیشود. در این حالت، کیفیت و ارزش مستقل را بررسی کنید: آیا صفحه به پرسش مشخصی پاسخ میدهد؟ آیا از صفحات مشابه چیزی بیشتر ارائه میکند؟ آیا متن قابل اعتماد، بهروز و قابل فهم است؟ آیا عنوان وعدهای میدهد که بدنه پاسخ نمیدهد؟ آیا صفحه صرفاً برای پر کردن یک city keyword یا کلمه کلیدی ساخته شده است؟
راهحل، افزودن پاراگرافهای عمومی نیست. intent را دوباره تحلیل کنید، محتوای کمارزش را ادغام کنید، نمونه واقعی، داده، فرایند، مقایسه یا پاسخ کاربردی اضافه کنید و مسیر داخلی را اصلاح کنید. هدف صفحه باید برای انسان قابل توضیح باشد. اگر تیم شما نمیتواند در یک جمله بگوید این URL چرا باید وجود داشته باشد، احتمالاً مشکل فقط ایندکس نیست؛ مشکل معماری و استراتژی محتواست.
دلیل دهم: مشکل امنیتی یا Manual Action
در Search Console بخش Manual Actions و Security Issues را بررسی کنید. هک، تزریق صفحات اسپم، ریدایرکت مخفی، محتوای فریبنده یا دسترسی غیرمجاز ممکن است وضعیت ایندکس و اعتماد دامنه را تحت تأثیر قرار دهد. در چنین شرایطی، تغییر title یا ارسال Request Indexing اولویت نیست؛ باید دسترسیها، فایلها، دیتابیس، DNS، CDN و لاگها بررسی و سایت پاکسازی شود.
از backup سالم استفاده کنید، رمزها و دسترسیهای حساس را تغییر دهید، 2FA فعال کنید و پس از اصلاح، درخواست بازبینی امنیتی را طبق دستورالعمل گوگل انجام دهید. برای تشخیص افت ناشی از حمله نیز راهنمای سئو منفی و دفاع از سایت را با ممیزی فنی ترکیب کنید.
فرایند عملی رفع ایندکس نشدن صفحه
برای اینکه تیم در حلقه درخواستهای تکراری گرفتار نشود، یک workflow ثابت داشته باشید. هر URL باید با علت، اقدام، مسئول و تاریخ پیگیری ثبت شود. این روش مخصوصاً برای سایتهای چندنفره و فروشگاهی که صفحات زیادی دارند، جلوی تغییرات تصادفی و حذف سیگنالهای مفید را میگیرد.
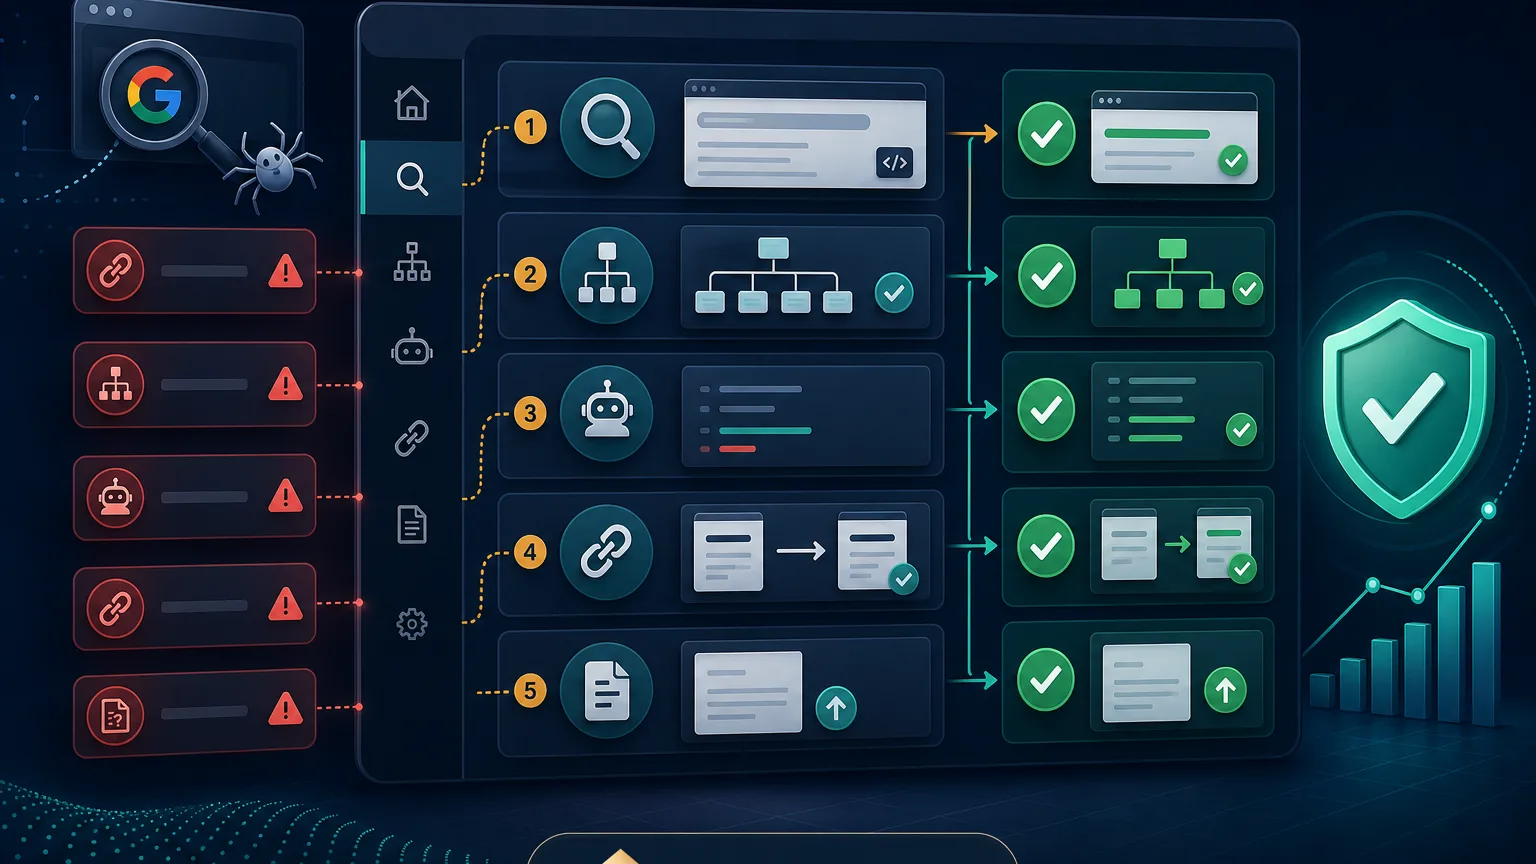
- دامنه را مشخص کنید: مشکل یک URL است، یک template، یک پوشه یا کل دامنه؟
- URL Inspection را اجرا کنید: وضعیت ایندکس، crawl، canonical و امکان دسترسی را ثبت کنید.
- HTML و header را ببینید: noindex، canonical، status code و محتوای اولیه را بررسی کنید.
- robots و sitemap را کنترل کنید: مسدودیت ناخواسته و URLهای ناسالم را حذف کنید.
- لینک داخلی بسازید: از صفحات مرتبط با anchor طبیعی و مقصد صحیح لینک دهید.
- کیفیت و تفاوت را ارزیابی کنید: محتوای تکراری، thin و صفحات بدون intent را ادغام یا تقویت کنید.
- مشکل سرور و رندر را رفع کنید: پاسخ 200 پایدار و HTML قابل پردازش تحویل دهید.
- Request Indexing را هدفمند بفرستید: فقط بعد از اصلاح و برای URLهای اولویتدار.
- پیگیری کنید: گزارش Pages، لاگ و عملکرد Search Console را در بازه مناسب دوباره بسنجید.
رفع ایندکس نشدن سایت وردپرسی
در وردپرس ابتدا تنظیمات خواندن سایت را بررسی کنید و مطمئن شوید گزینه جلوگیری از موتورهای جستوجو فعال نیست. سپس افزونه سئو، قالب، افزونههای کش و redirect را بررسی کنید؛ چند منبع همزمان ممکن است robots یا canonical متفاوت تولید کنند. View Source چند نوع صفحه، از مقاله و دسته تا محصول و صفحه اصلی، را با هم مقایسه کنید.
برای مقالههای جدید، permalink پایدار، لینک داخلی از مطالب قدیمی، sitemap افزونه و وضعیت URL Inspection را کنترل کنید. اگر افزونه برای همه صفحات آرشیو noindex گذاشته، تصمیم را بر اساس ارزش واقعی آرشیو بگیرید؛ باز کردن همه taxonomyها بدون محتوای مفید هم راهکار نیست. پس از تغییرات، cache صفحه و CDN را پاک کنید و HTML واقعی production را تست کنید.
رفع ایندکس نشدن در Next.js App Router
در Next.js، خروجی metadata در generateMetadata، canonical، robots و routeهای داینامیک را بررسی کنید. اگر notFound() یا middleware برای slugهای معتبر بهاشتباه اجرا شود، صفحات به 404 یا پاسخ غیرمنتظره میرسند. مطمئن شوید generateStaticParams، داده production و مسیرهای واقعی همخواناند و صفحهها فقط بعد از تعامل client ساخته نمیشوند.
export async function generateMetadata({ params }) {
  const post = await getPost(params.slug);

  return {
    title: post.title,
    description: post.excerpt,
    robots: { index: true, follow: true },
    alternates: {
      canonical: `/blog/${post.slug}`,
    },
  };
}
پس از deploy، curl یا View Source را برای یک URL واقعی اجرا کنید و status، title، canonical، robots و متن را بررسی کنید. build موفق بهتنهایی سلامت ایندکس را ثابت نمیکند؛ خطای runtime در production، تفاوت environment یا داده ناقص میتواند فقط روی چند مسیر اثر بگذارد.
چطور از تکرار مشکل ایندکس جلوگیری کنیم؟
برای انتشار، checklist فنی اجباری داشته باشید: یک URL و intent مشخص، canonical خودارجاع، نبود noindex ناخواسته، لینک داخلی ورودی، حضور در sitemap، پاسخ 200، title و H1 هماهنگ، محتوای مستقل و تست موبایل. تغییرات robots، metadata، routing و template باید review شوند. بعد از انتشار batch بزرگ، Search Console و لاگ را بهصورت نمونهای پایش کنید؛ خطا را ماهها بعد از افت ترافیک کشف نکنید.
همچنین orphan pageها را دورهای پیدا کنید. مقالهای که در sitemap هست ولی از هیچ صفحه مرتبط لینک ندارد، در معرض کشف ضعیف و نادیدهگرفتهشدن قرار میگیرد. لینکسازی داخلی را با هدف معماری انجام دهید، نه تزریق لینک در همه پاراگرافها. در صورت نیاز به ممیزی کامل، ممیزی سئو تکنیکال و خدمات سئو روبینش مسیر بررسی مرحلهای را فراهم میکنند.
جدول تصمیم سریع برای خطاهای ایندکس
| پیام یا نشانه | علت محتمل | اقدام اول |
|---|---|---|
| Excluded by noindex | meta یا header محدودکننده | بررسی source و header و اصلاح template |
| Blocked by robots.txt | Disallow ناخواسته | اصلاح robots و تست نسخه production |
| Duplicate / different canonical | شباهت URL یا canonical نادرست | تصمیم ادغام، redirect یا canonical خودارجاع |
| Crawled - currently not indexed | ارزش مستقل یا تفاوت کم | تحلیل intent، کیفیت و لینک داخلی |
| Server error | 5xx، timeout یا محدودیت CDN | بررسی لاگ و پایداری پاسخ 200 |
جمعبندی: قبل از درخواست ایندکس، علت را پیدا کنید
ایندکس نشدن سایت در گوگل میتواند فنی، معماری، محتوایی یا امنیتی باشد. noindex، robots، canonical، نبود لینک داخلی، duplicate، خطای سرور، رندر ناقص و کیفیت پایین هرکدام مسیر تشخیص متفاوتی دارند. Request Indexing فقط یک درخواست بررسی است و نباید جای رفع علت را بگیرد.
با URL Inspection شروع کنید، source و header واقعی را ببینید، گزارش Pages را دستهبندی کنید و بعد اصلاح را با sitemap، لینک داخلی و محتوای مستقل کامل کنید. اگر مشکل در چند template یا کل سایت دیده میشود، بهجای اصلاح دستی URLها، معماری و pipeline انتشار را بررسی کنید. برای دریافت کمک در ممیزی و اجرای اصلاحات نیز میتوانید از صفحه تماس روبینش استفاده کنید.
سؤالات متداول
چرا سایت در گوگل ایندکس نمیشود؟
دلایل رایج شامل noindex، مسدود شدن در robots.txt، canonical اشتباه، نبود لینک داخلی، محتوای تکراری یا کمارزش، خطای سرور و رندر ناقص JavaScript است.
آیا Request Indexing ایندکس شدن را فوری انجام میدهد؟
خیر، این گزینه فقط درخواست بررسی مجدد را ثبت میکند و تضمین یا زمان قطعی برای ایندکس شدن نیست. ابتدا باید علت فنی یا محتوایی رفع شود.
چطور بفهمیم noindex باعث ایندکس نشدن شده است؟
source HTML و response header را بررسی کنید و در Search Console گزارش Excluded by noindex را ببینید. ممکن است noindex از meta robots، X-Robots-Tag یا template تولید شده باشد.
آیا نبود لینک داخلی مانع ایندکس میشود؟
میتواند کشف و درک اهمیت صفحه را دشوار کند، مخصوصاً وقتی URL فقط در sitemap قرار دارد. صفحه مهم باید از صفحات مرتبط با anchor طبیعی لینک ورودی داشته باشد.
بعد از رفع مشکل ایندکس چه کاری انجام دهیم؟
HTML و status را دوباره تست کنید، sitemap و لینک داخلی را اصلاح کنید، سپس برای URLهای اولویتدار Request Indexing بفرستید و وضعیت Pages و URL Inspection را در بازه مناسب پایش کنید.