اسکرپ نظرات و امتیاز؛ تحلیل احساسات بازار از داده عمومی
اسکرپ نظرات و امتیاز یعنی جمعآوری مسئولانهٔ بازخوردهای عمومی برای فهم روند رضایت، شکایتهای تکراری و نقاط ضعف محصول؛ نه کپیکردن هویت افراد یا ساختن امتیاز جعلی. ارزش کار در سؤال درست، منبع مجاز، حذف دادهٔ شخصی و تحلیل قابلتکرار است. یک فایل بزرگ از متن خام، بدون تاریخ و منبع، هنوز تحلیل بازار نیست.
جستوجوهایی مثل «اسکرپ نظرات مشتریان»، «جمعآوری review»، «تحلیل امتیاز رقبا»، «تحلیل احساسات نظرات» و «استخراج کامنت برای تحلیل بازار» نیت مشخصی دارند: تیم میخواهد بداند مشتریان دقیقاً از چه چیزی راضی یا ناراضیاند. این مقاله روی طراحی داده و تحلیل تمرکز دارد، نه تعریف عمومی وب اسکرپینگ در راهنمای اسکرپ دیتا و نه جمعآوری لید در راهنمای جمعآوری لید از وب. برای اجرای پروژه، صفحه خدمات اسکرپ دیتا روبینش مسیر تجاری است.
Personal data shall be collected for specified, explicit and legitimate purposes and not further processed in a manner that is incompatible with those purposes.
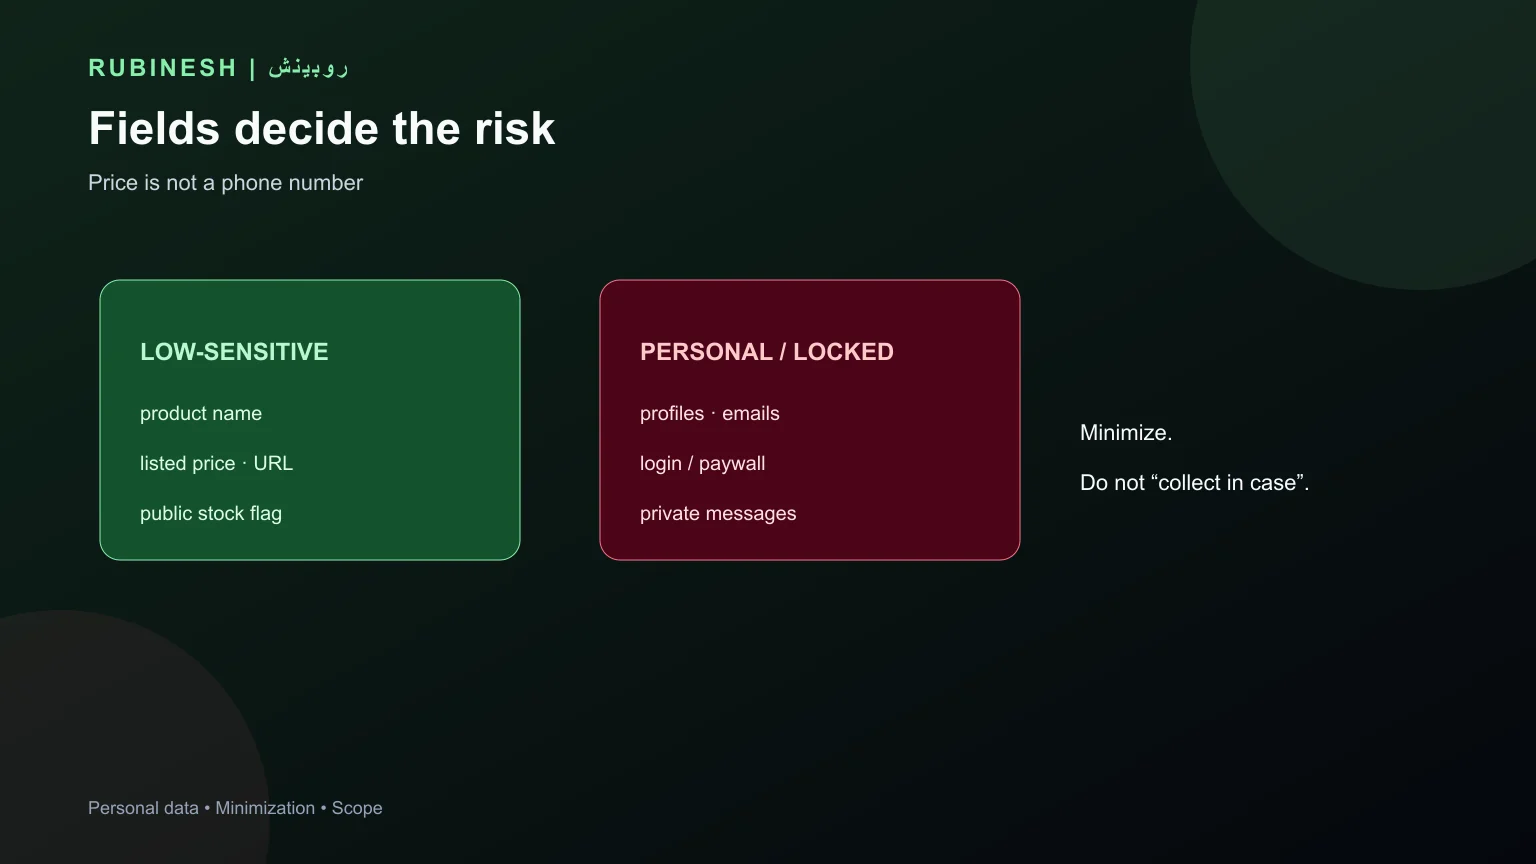
در اسکرپ نظر چه فیلدهایی جمع کنیم؟
قبل از ابزار، قرارداد داده بنویسید. فیلدهای پایه میتواند شامل متن نظر، امتیاز عددی، تاریخ انتشار، تاریخ آخرین ویرایش، شناسهٔ عمومی نظر، پاسخ کسبوکار، زبان و URL منبع باشد. نام نمایشی را فقط وقتی نگه دارید که برای تحلیل لازم و عمومی باشد؛ تصویر، ایمیل، تلفن و لینک پروفایل شخصی معمولاً برای سؤال محصول لازم نیستند. کمینهسازی داده هم ریسک را کم میکند و هم مدل تحلیل را تمیزتر نگه میدارد.
متن خام را حذف نکنید، اما دو نسخه داشته باشید: raw برای امکان بازبینی و normalized برای تحلیل. در نسخهٔ نرمال، فاصله، نیمفاصله و نویسههای عربی/فارسی را استاندارد کنید، بدون اینکه معنی متن را عوض کنید. امتیاز را عدد جدا بگذارید و «۵ از ۵» را در متن خام نگه دارید. نوع فیلد و قواعد نرمالسازی را با رویکرد پاکسازی داده اسکرپ ثبت کنید.
| فیلد | کاربرد | احتیاط |
|---|---|---|
| متن نظر | دستهبندی موضوع و احساس | ممکن است دادهٔ شخصی داشته باشد |
| امتیاز | روند رضایت و مقایسهٔ زمانی | مقیاس منابع متفاوت است |
| تاریخ | تشخیص تغییر بعد از محصول یا کمپین | منطقه و ویرایش باید روشن باشد |
| پاسخ برند | سنجش کیفیت رسیدگی | با متن مشتری قاطی نشود |
| شناسه عمومی | حذف تکرار در برداشت بعدی | نباید به هویت خصوصی گسترش یابد |
کدام منبع برای جمعآوری review مناسب است؟
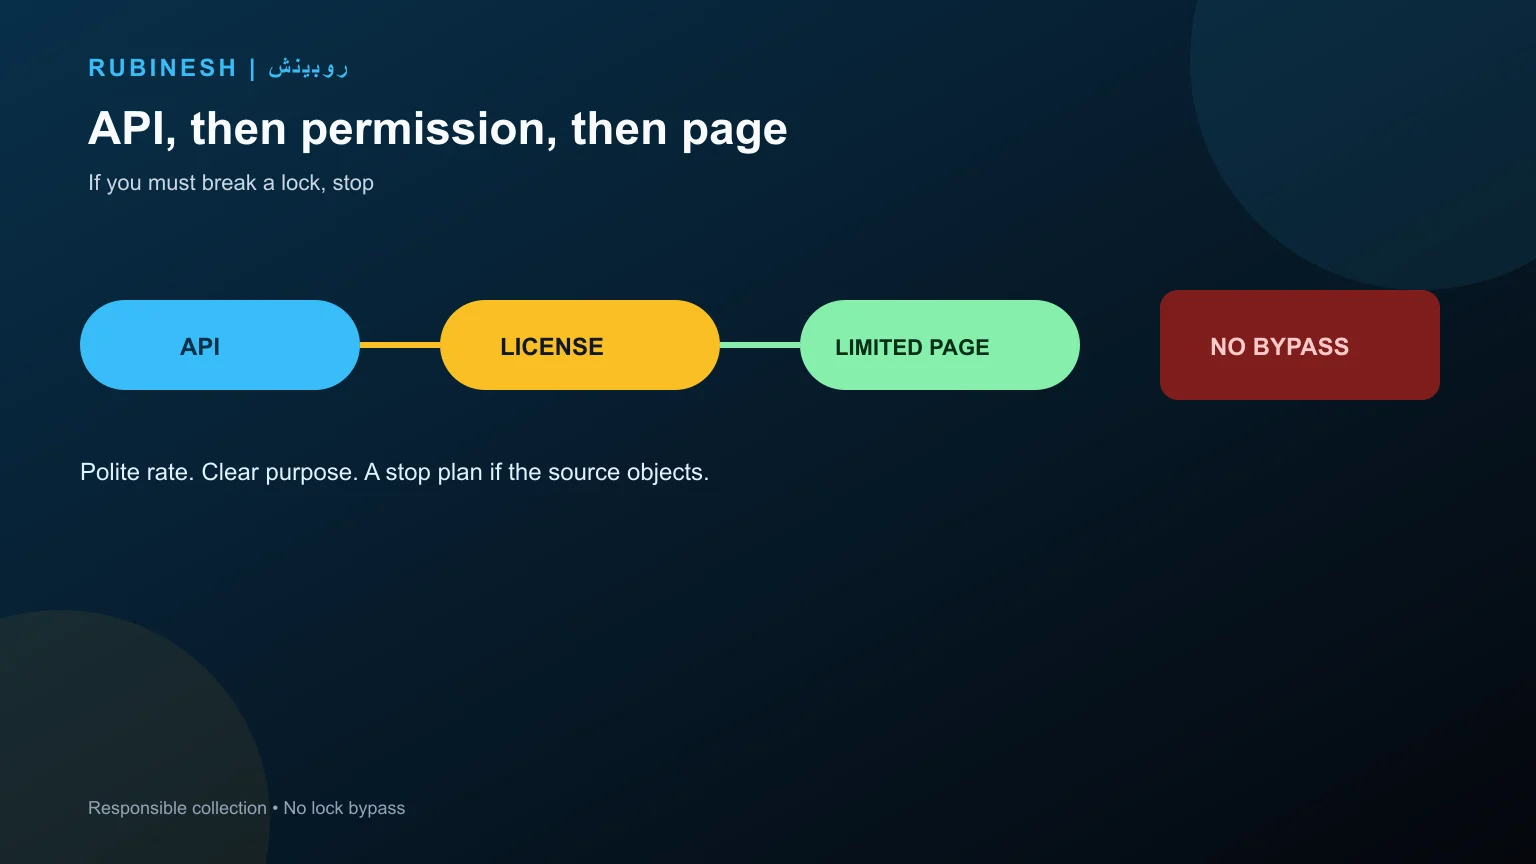
منبع مناسب فقط منبعی نیست که متن نظر در آن دیده میشود؛ شرایط استفاده، API و محدودیت برداشت آن هم مهم است. اگر API رسمی یا export مجاز وجود دارد، همان مسیر را به اسکرپ صفحه ترجیح دهید. robots.txt دربارهٔ خزش است و جایگزین شرایط استفاده یا مجوز داده نیست. در راهنمای قانونی بودن وب اسکرپینگ دربارهٔ این مرزها بیشتر نوشتهایم.
از صفحات پشت حساب کاربری، پیام خصوصی و دادهای که برای عموم منتشر نشده برداشت نکنید. CAPTCHA و محدودیت سرویس را با روشهای پنهان دور نزنید. اگر کسبوکار برای بررسی به دادهٔ بیشتری نیاز دارد، از منبع درخواست مجوز، دادهٔ تجمیعی یا خروجی رسمی بگیرید. «برای تحلیل داخلی» بهتنهایی مجوز همهٔ روشها نیست.
منبع را کنار هر رکورد نگه دارید: domain، URL، زمان برداشت و نسخهٔ parser. این کار برای بازبینی و حذف داده در صورت نیاز ضروری است. اگر منبع تغییر کرد، میفهمید کدام ردیف تحتتأثیر است. تفاوت قرارداد رسمی و استخراج صفحه را در مقایسهٔ اسکرپ و API ببینید.
چطور نظرات تکراری را حذف کنیم؟
تکرار ممکن است از صفحهبندی، زبان، فیلتر، پاسخگویی یا برداشت دوبارهٔ یک صفحه ایجاد شود. بهترین کلید همان شناسهٔ عمومی منبع است؛ اگر وجود ندارد، URL نرمال، تاریخ، امتیاز و بخشی از متن را فقط بهعنوان کلید کمکی ترکیب کنید. شباهت متنی را با حذف فاصله و نویسههای بیمعنی شروع کنید، نه با حذف تکههای بلند که ممکن است دو نظر متفاوت را یکی کند.
دو نسخه از یک نظر را بیدلیل به دو مشتری تبدیل نکنید. فیلد source_review_id، تاریخ برداشت و hash متن کمک میکند تغییر متن، ویرایش و تکرار از هم جدا شوند. اگر متن ویرایش شده، نسخهٔ جدید را جایگزین یا version کنید؛ تصمیم را به سؤال تحلیل وابسته کنید. برای تحلیل روند، تاریخ انتشار با تاریخ برداشت یکی نیست.
تحلیل احساسات را چطور قابلاعتماد کنیم؟
تحلیل احساسات برچسب قطعی حقیقت نیست؛ یک تخمین وابسته به زبان، موضوع و زمینه است. «بد نیست» ممکن است در یک حوزه رضایت و در حوزهای دیگر نارضایتی باشد. در فارسی، نیمفاصله، کنایه، غلط املایی و ترکیب فارسی/انگلیسی مدل عمومی را ضعیف میکند. ابتدا نمونهای را دستی برچسب بزنید و بدانید مدل در چه مواردی اشتباه میکند.
سه کلاس مثبت، منفی و خنثی برای شروع کافی است، اما برای تصمیم محصول معمولاً موضوع هم لازم است: قیمت، ارسال، کیفیت، پشتیبانی، رابط یا اعتماد. یک نظر ممکن است دربارهٔ ارسال مثبت و دربارهٔ کیفیت منفی باشد. برچسب کلی آن، اقدام تیم را گم میکند. خروجی مدل را همراه با confidence، نسخهٔ مدل و امکان بازبینی انسانی ذخیره کنید.
از میانگین امتیاز بهتنهایی نتیجه نگیرید. توزیع ۱ تا ۵، حجم نمونه، تاریخ و ترکیب منبع را کنار هم ببینید. صد نظر در یک ماه با هزار نظر در پنج سال قابل مقایسه نیست. تحلیل نظرات باید به سؤال مشخص جواب دهد: «بعد از تغییر زمان ارسال، شکایت دربارهٔ تحویل کم شده؟» نه اینکه فقط یک نمرهٔ زیبا بسازد.
از متن review چه موضوعاتی استخراج کنیم؟
واژههای پرتکرار بهتنهایی کافی نیستند؛ موضوع را با نیاز کسبوکار تعریف کنید. در فروشگاه ممکن است ارسال، بستهبندی، اصالت و بازگشت مهم باشند. در SaaS، سرعت، قطعی، پشتیبانی و یادگیری مطرح است. در کلینیک، زمان انتظار، پاسخگویی و تجربهٔ رزرو مهم است. taxonomy باید کوتاه باشد و با چند نمونهٔ واقعی آزموده شود.
برای هر موضوع، نمونهٔ مثبت و منفی نگه دارید. اگر «سریع» گاهی در جملهٔ «پاسخ سریع نبود» میآید، جستوجوی ساده کافی نیست. ruleهای روشن، مدل زبانی یا ترکیب هر دو میتواند کمک کند، اما خروجی باید قابلتوضیح باشد. موضوعهای جدید را بهعنوان unknown نگه دارید تا مجبور نباشید هر متن را به یکی از دستههای قدیمی هل دهید.
خروجی تحلیل را چطور به محصول وصل کنیم؟
خروجی مفید یک فایل کلمات پرتکرار نیست؛ فهرستی از تصمیمهای قابل پیگیری است. نمونه: «شکایت ارسال در شهر X طی شش هفته بالا رفته»، «امتیاز بعد از تغییر onboarding بهتر شده» یا «پاسخ برند به نظرهای منفی دیر است». هر نتیجه باید بازهٔ زمانی، منبع، حجم نمونه و محدودیت را داشته باشد.
دادهٔ review را مستقیم وارد CRM فروش نکنید مگر هدف روشن باشد. برای تیم محصول، issue یا backlog مناسبتر است؛ برای پشتیبانی، صف موضوع و اولویت؛ برای بازاریابی، پیام و صفحهٔ پاسخ. اتصال به سیستم داخلی را در توسعه نرمافزار اختصاصی میتوان بر اساس فرآیند واقعی طراحی کرد. دادهٔ خام باید دسترسی محدود و retention مشخص داشته باشد.
حریم خصوصی و نگهداری داده
پیش از برداشت، هدف، فیلدهای ضروری، مدت نگهداری و افراد مجاز به دسترسی را بنویسید. دادهای که برای داشبورد لازم نیست، جمع نکنید. نام نمایشی را hash یا حذف کنید اگر تحلیل بدون آن انجام میشود. دادههای حساس، سلامت، موقعیت دقیق یا اطلاعات تماس شخصی را از پروژهٔ عمومی review جدا کنید و برای موارد خاص بررسی حقوقی بگیرید.
اگر فرد یا منبع درخواست حذف یا اصلاح دارد، باید بدانید رکورد در کجا ذخیره شده است. نگهداری hash و شناسه داخلی برای اجرای این فرایند مفید است، اما hash را مجوز نگهداری متن نمیدانید. دسترسی تحلیلگر، خروجی CSV و نسخهٔ backup هم بخشی از چرخهٔ دادهاند. امنیت فقط زمان کرال نیست؛ زمان اشتراکگذاری و آرشیو هم هست.
اشتباهات رایج اسکرپ نظرات
- یکی گرفتن دادهٔ عمومی با اجازهٔ نامحدود برداشت
- ذخیرهٔ نام، تصویر و پروفایل شخصی بدون نیاز تحلیلی
- مقایسهٔ امتیاز منابع با مقیاس و جامعهٔ متفاوت
- اعتماد کامل به برچسب احساسات بدون نمونهبرداری انسانی
- قاتی کردن پاسخ برند با متن مشتری
- حذف تاریخ، منبع و شناسهٔ تکرار از خروجی
- تبدیل فهرست خام به کمپین تماس یا پیام ناخواسته
چکلیست پروژه اسکرپ review
- سؤال محصول و تصمیمی که باید پشتیبانی شود مشخص است.
- منبع، API و شرایط استفاده بررسی شدهاند.
- فیلدهای ضروری و دادهٔ ممنوع از هم جدا شدهاند.
- شناسه، URL، تاریخ برداشت و نسخهٔ parser ذخیره میشوند.
- متن خام و نسخهٔ نرمال جدا نگهداری میشوند.
- تکرار، ویرایش و زبان در مدل داده دیده شده است.
- نمونهٔ برچسبخورده برای ارزیابی احساسات وجود دارد.
- موضوعها محدود، قابلتوضیح و قابلاصلاح هستند.
- حذف، دسترسی و مدت نگهداری داده مشخص شده است.
جمعبندی: review را به تصمیم وصل کنید
اسکرپ نظرات و امتیاز وقتی ارزش دارد که منبع مجاز، فیلد کمینه، تاریخ و کلید تکرار داشته باشد و تحلیل آن به سؤال مشخص محصول جواب دهد. متن خام، میانگین امتیاز و برچسب خودکار بهتنهایی تصمیم نمیسازند. حریم خصوصی، شرایط استفاده و امکان بازبینی بخشی از معماری دادهاند، نه یادداشت انتهای پروژه.
برای طراحی مسیر جمعآوری، پاکسازی و تحویل داده از منابع مجاز، خدمات کرالر و اسکرپ دیتا روبینش را ببینید و برای تعریف نیاز واقعی از فرم تماس شروع کنید. حجم بیشتر جایگزین سؤال درست و منبع قابلاعتماد نیست.
سؤالات متداول
اسکرپ نظرات مشتریان چیست؟
جمعآوری مسئولانه متن نظر، امتیاز، تاریخ و پاسخ برند از منابع عمومی مجاز برای تحلیل روند رضایت و شکایت است؛ نه برداشت داده خصوصی.
آیا هر نظر عمومی را میتوان اسکرپ کرد؟
خیر. شرایط استفاده، API، robots.txt، نوع داده و قوانین حریم خصوصی باید بررسی شوند و منبع نامجاز یا داده شخصی از محدوده خارج است.
برای تحلیل نظرات چه فیلدهایی لازم است؟
متن، امتیاز، تاریخ، URL و شناسه عمومی نظر معمولاً کافیاند. نام، تصویر و اطلاعات شخصی فقط در صورت نیاز روشن و مجاز بررسی میشوند.
تحلیل احساسات نظرات چقدر دقیق است؟
به زبان، موضوع و نمونه آموزشی وابسته است. در فارسی باید نمونه را دستی ارزیابی کرد و خروجی نامطمئن را برای بازبینی انسانی نگه داشت.