Playwright و اسکرپ سایتهای جاوااسکریپتی
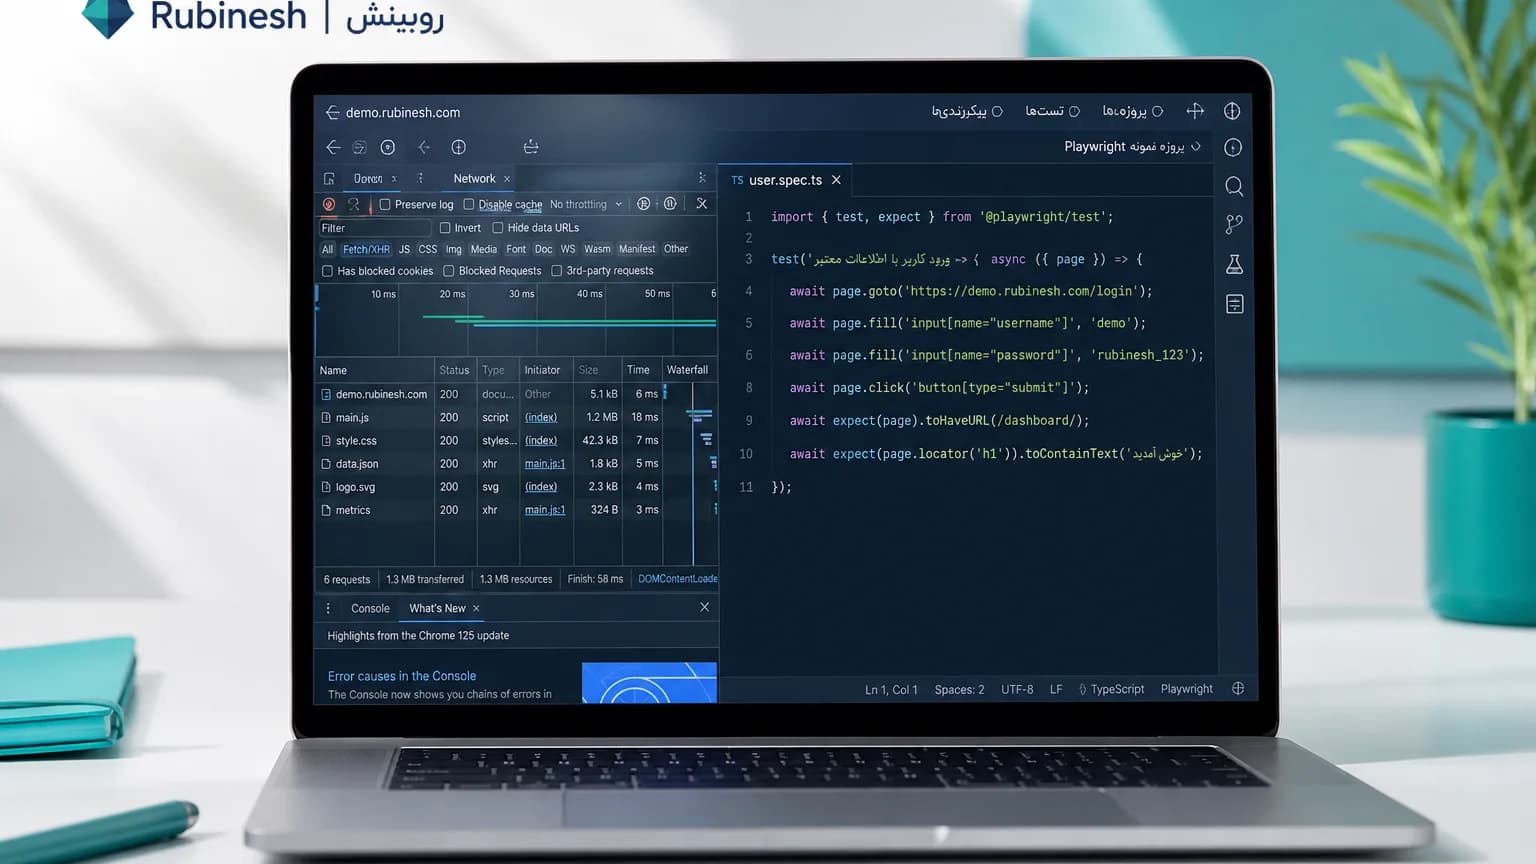
اگر میپرسید اسکرپ با Playwright یعنی چه، پاسخ این است: وقتی دادهٔ عمومی فقط بعد از اجرای جاوااسکریپت در مرورگر دیده میشود، یک درخواست HTTP خام HTML خالی یا ناقص برمیگرداند و باید همان صفحه را در مرورگر واقعی رندر کرد. Playwright چارچوب اتوماسیون مرورگر است، نه میانبر دورزدن قفل. کارش خواندن DOM بعد از رندر است؛ جایگزین API رسمی و مجوز منبع نیست.
پیشنهاد گوگل و جستوجوهای نزدیک معمولاً این نیت را دارند: «Playwright چیست»، «اسکرپ سایت جاوا اسکریپتی»، «تفاوت Playwright و Scrapy»، «تفاوت Playwright و Selenium»، «اسکرپ SPA»، «سلکتور پایدار» و «هزینه مرورگر هدلس». در این راهنما تعریف، زمان کافینبودن HTML، مرز با Scrapy، پایداری سلکتور و هزینهٔ اجرا را مینویسیم. تعریف استخراج را در اسکرپ دیتا چیست ببینید، قرارداد دسترسی را در تفاوت اسکرپ و API، و محدودهٔ مسئولانه را در وب اسکرپینگ قانونی است. اجرای پروژههای مجاز در خدمت اسکرپ داده روبینش است.
Playwright is an open-source automation library for browser testing. Playwright can automate Chromium, Firefox and WebKit with a single API.
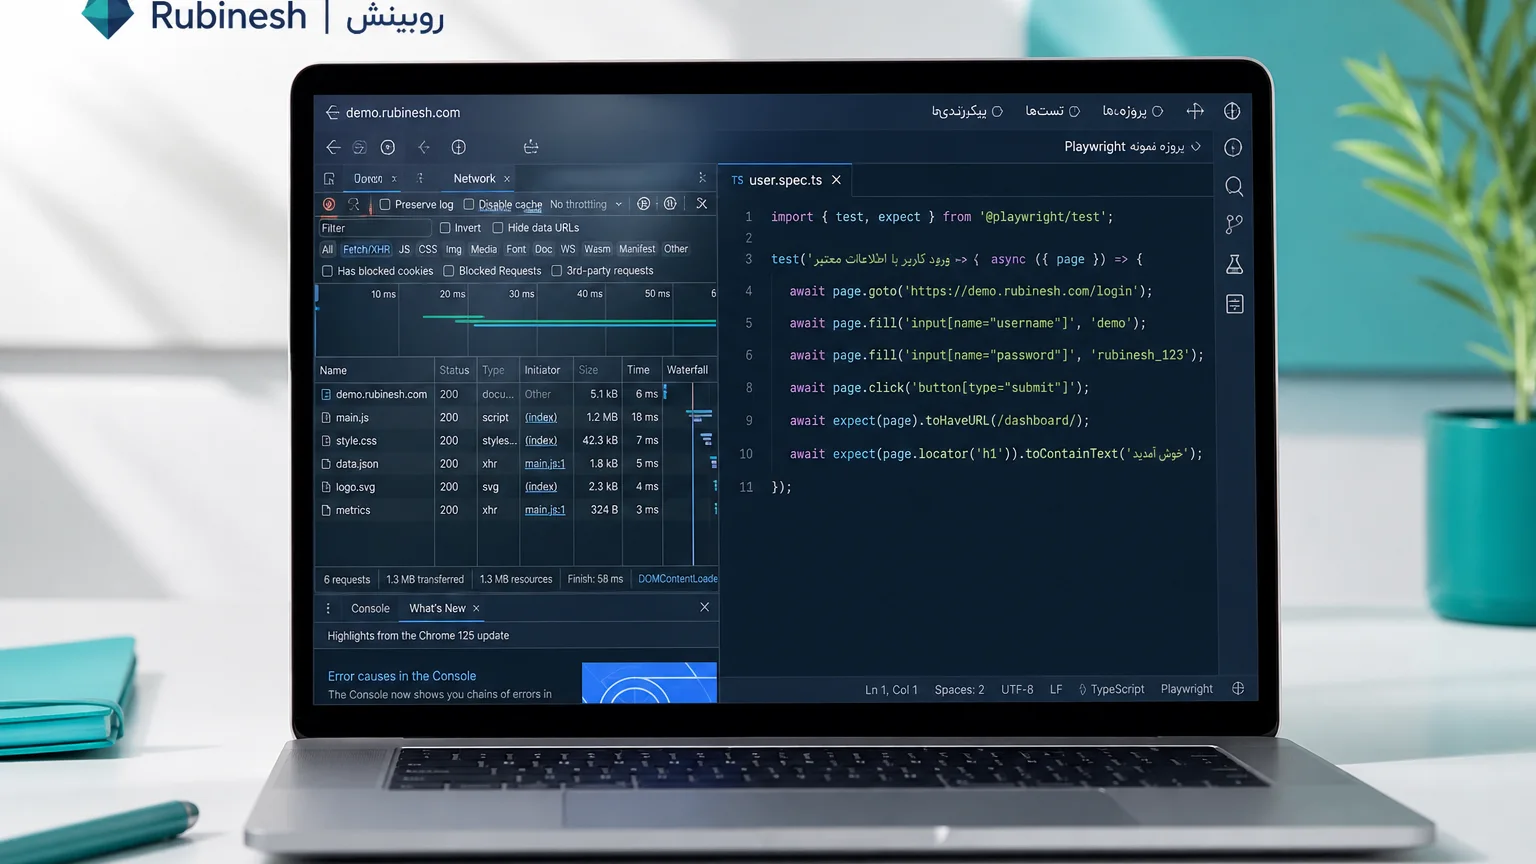
Playwright چیست و برای اسکرپ چه نقشی دارد؟
Playwright کتابخانهای است که کرومیوم، فایرفاکس و وبکیت را از یک API کنترل میکند. برای تست رابط ساخته شده، اما همان کنترل برای خواندن صفحهٔ عمومی بعد از رندر هم بهکار میرود: باز کردن URL مجاز، صبر تا عنصر مشخص ظاهر شود، و برداشتن متن قیمت یا عنوان از DOM. این با کرالر لینکیاب فرق دارد. کشف URL را در کرالر چیست جدا نگه دارید؛ اینجا رندر است نه خزیدن بیپایان.
ابزار تست را با مجوز برداشت قاطی نکنید. اینکه بتوانید صفحه را در مرورگر خودتان باز کنید، بهمعنی اجازهٔ استخراج انبوه نیست. robots.txt، شرایط استفاده و نوع داده همچنان اول میآیند. این مقاله روش ورود به ناحیهٔ قفل، حل کپچا یا پنهانکردن ربات را آموزش نمیدهد. اگر بدون آنها داده در دسترس نیست، منبع را از محدوده حذف کنید یا خوراک رسمی بخواهید.
خروجی باید همان فیلد توافقشده باشد: عنوان، قیمت عددی، URL، زمان برداشت. اسکرین شات زیبا داده نیست. اگر بعد از رندر هنوز فیلد در DOM نیست — مثلاً داخل تصویر یا بوم — Playwright معجزه نمیکند. آن محدودیت را قبل از برآورد بنویسید.
| آنچه در پاسخ HTTP میبینید | مسیر اول | چرا |
|---|---|---|
| عنوان و قیمت داخل HTML | درخواست معمولی | ارزانتر و پایدارتر |
| JSON داخل اسکریپت صفحه | پارس همان پاسخ | مرورگر چیزی اضافه نمیکند |
| کارتها فقط بعد از اجرای JS | رندر انتخابی | DOM همان منبع است |
| فیلد فقط در API رسمی | قرارداد API | اسکرپ صفحه اتلاف است |
کی HTML کافی نیست؟
فروشگاههای مدرن اغلب فهرست کالا را با جاوااسکریپت میسازند. درخواست ساده یک پوسته خالی برمیگرداند. اگر در ابزار توسعهدهنده، بعد از بارگذاری، کارتها در DOM هستند، رندر معنا دارد. اگر همان داده در درخواست شبکه بهصورت JSON عمومی میآید، همان JSON را با قرارداد و نرخ محترمانه بخوانید؛ روشنکردن مرورگر هزینهٔ اضافه است.
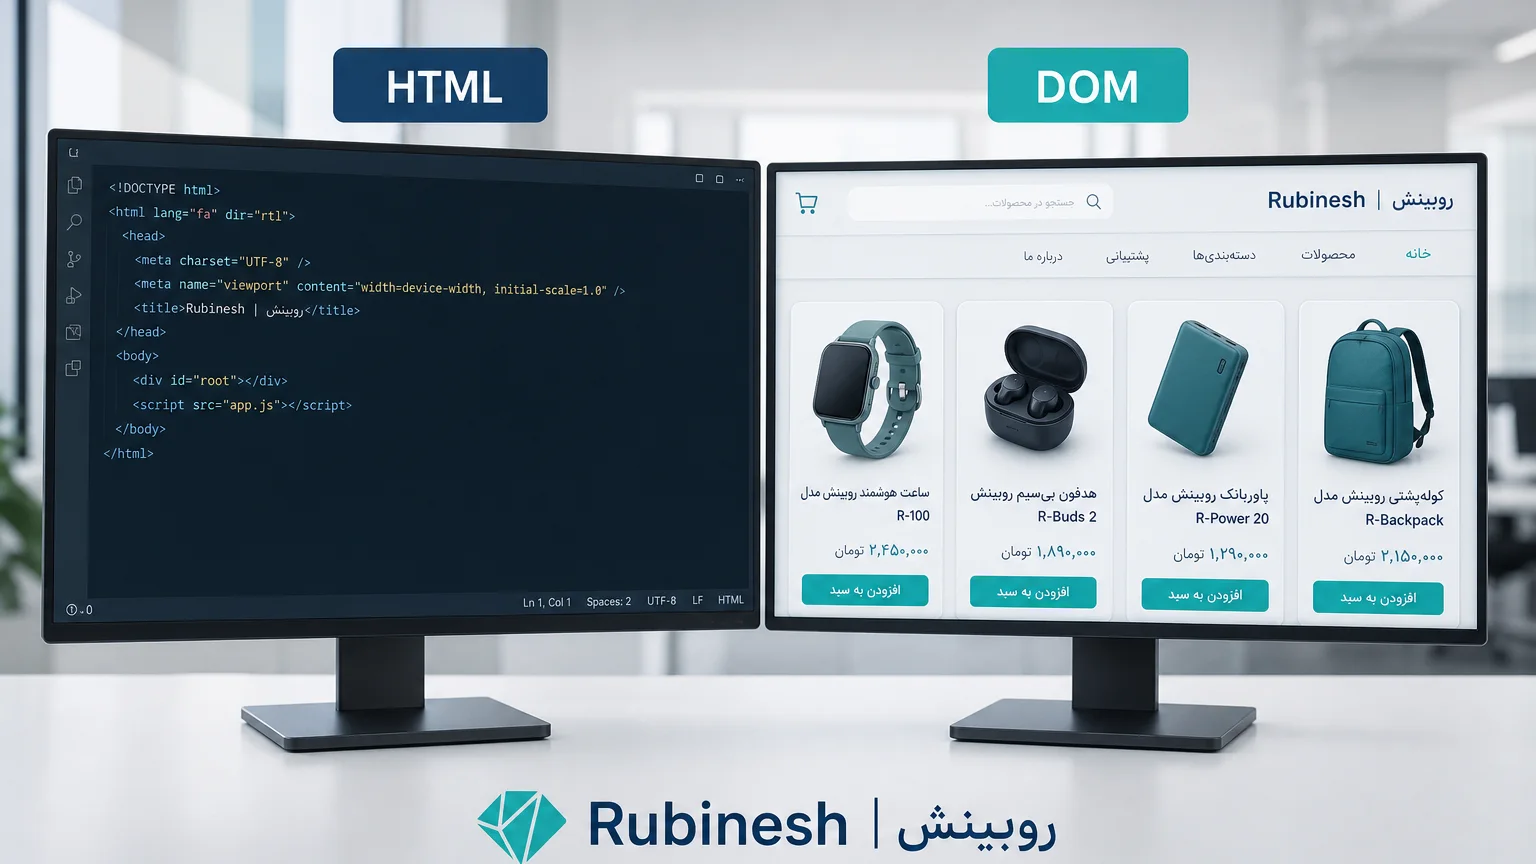
صفحهٔ فیلتر که نتایج را بدون بارگذاری مجدد عوض میکند همین الگو را دارد. صرافی که جدول نرخ را سمت کلاینت بهروز میکند هم ممکن است HTML اولیه را خالی بگذارد؛ معماری ویترین را در طراحی سایت صرافی جدا ببینید و اسکرپ را با دورزدن احراز قاطی نکنید. گردشگری که تور را با فیلتر تاریخ میآورد اگر ترکیب را در HTML ندهد، رندر یا API رسمی مطرح میشود — سیاست URL را در سئو سایت گردشگری بخوانید نه بهعنوان دستور خزیدن فیلتر بیپایان.
قانون عملی: یک URL نمونه را با درخواست ساده و با مرورگر مقایسه کنید. اگر فیلد در هر دو یکی است، مرورگر را برای تولید روشن نکنید. اگر فقط در مرورگر هست، همان درخواستها را در محدودهٔ مجاز و با تأخیر اجرا کنید. حجم را از نمونه بسنجید؛ «همهٔ سایت» برآورد نیست.
تفاوت Playwright با Scrapy و Selenium چیست؟
Scrapy زمانبند، صف و خط لولهٔ آیتم است و پیشفرض مرورگر باز نمیکند. برای HTML ایستا سریع و کمهزینه است. Playwright مرورگر واقعی است: حافظه، CPU و نسخهٔ مرورگر میخواهد. یکی جایگزین دیگری نیست. تیم بالغ HTML را با زمانبند HTTP میگیرد و فقط URLهایی را که واقعاً به DOM نیاز دارند به رندر میسپارد.
Selenium هم مرورگر را کنترل میکند، معمولاً با لایهٔ درایور جدا. Playwright مرورگر را همراه نصب میکند و انتظار برای ظاهر شدن عنصر در APIاش جاافتادهتر است. انتخاب ابزار تست موجود تیم را به اسکرپ تولید تبدیل نکنید. اگر سوئیت سلنیوم دارید، مهاجرت اجباری نیست؛ هزینهٔ نگهداری دو مسیر را بسنجید. این صفحه آموزش نصب حمله نیست — فقط مرز نقش است.
ادغام Scrapy با رندر انتخابی در پروژههای بزرگ رایج است: کشف و تکرار روی HTTP، رندر فقط برای برگههایی که نمونه ثابت کرده DOM لازم دارند. اگر همهٔ درخواستها را به مرورگر بدهید، هزینه خطی با تعداد URL بالا میرود و یک تغییر قالب همه را میخواباند.
پایداری سلکتور را چطور نگه داریم؟
کلاس CSS تصادفی با اولین بازطراحی میمیرد. سلکتور پایدار به نقش و متن مرئی نزدیکتر است: برچسب «قیمت»، ویژگی دسترسپذیری، یا ساختار تکرارشوندهٔ کارت — نه div.sc-a1b2. بعد از هر اجرا، تعداد کارت و نوع فیلد را چک کنید. اگر صفر شد، اجرا بایستد نه اینکه قیمت خالی را حقیقت فرض کند.
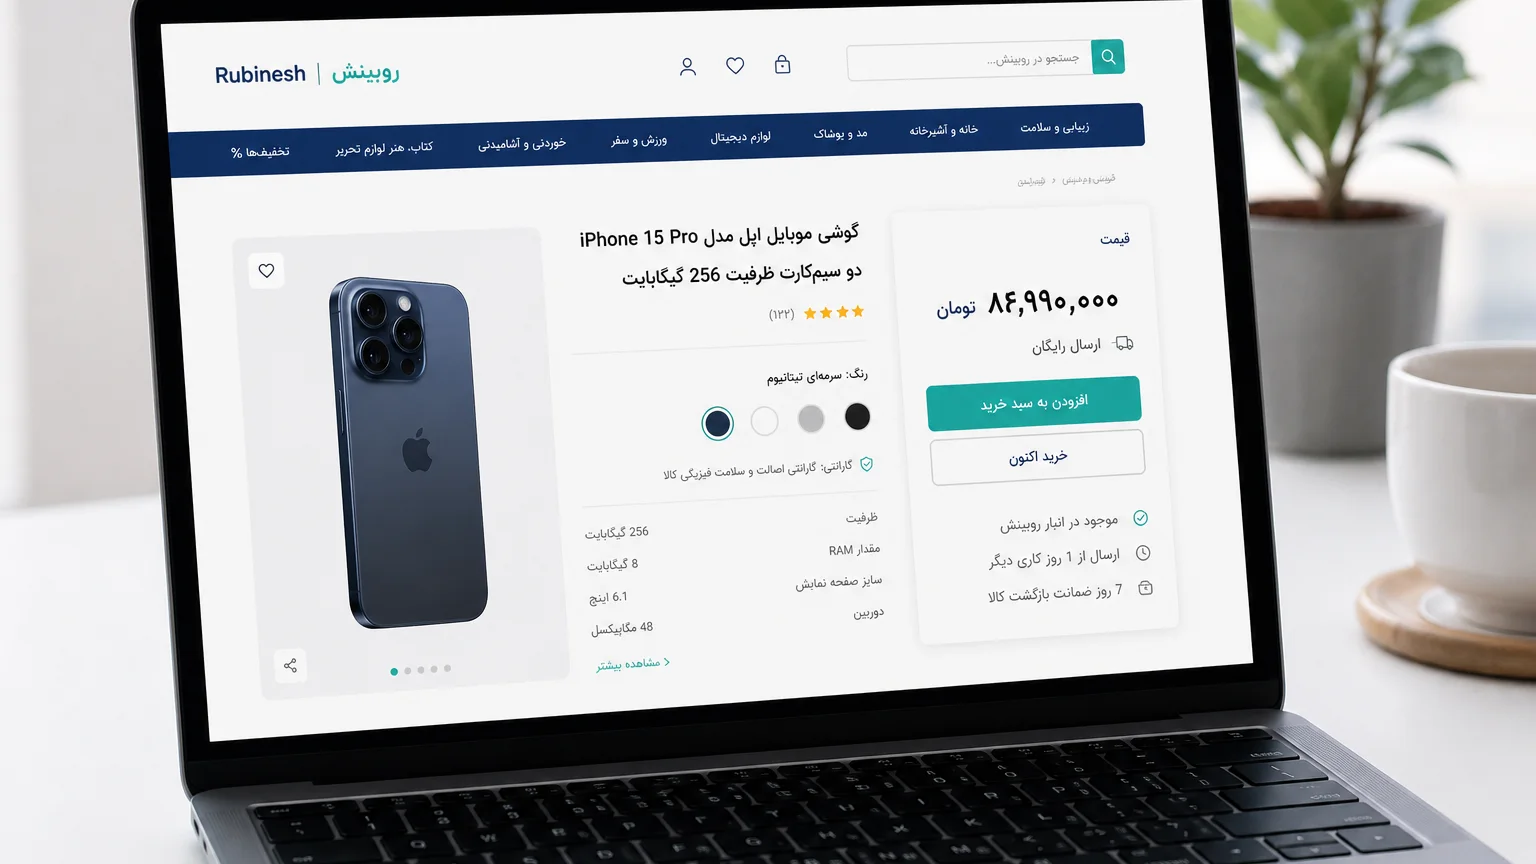
صبر را به زمان ثابت گره نزنید. «سه ثانیه sleep» در شبکهٔ کند دروغ میگوید و در شبکهٔ سریع پول میسوزاند. صبر تا سلکتور مشخص یا تا درخواست دادهٔ همان صفحه تمام شود دقیقتر است. متن فارسی طول برچسب را عوض میکند؛ نمونه را با عنوان واقعی بسنجید نه با lorem.
برای کاتالوگ کالا، شناسه را از URL پایدار یا SKU روی صفحه بگیرید نه از ترتیب کارت. تطبیق را در استخراج داده محصول جدا بنویسید تا این مقاله روی رندر بماند. پایش قیمت هم به همان سلکتور شکننده حساس است؛ هشدار تغییر را در مانیتورینگ قیمت رقبا ببینید.
هزینه اجرا از کجا میآید؟
هر نمونهٔ مرورگر RAM و CPU میگیرد. موازیسازی بیرویه سرور شما را میکشد و منبع مقصد را هم تحت فشار میگذارد. نرخ محترمانه بخشی از کیفیت است نه ضعف. مرورگر را بین درخواستهای همان دامنه بیخودی از نو روشن نکنید؛ و صفحه را بعد از خواندن ببندید تا نشت حافظه نسازد.
هزینهٔ پنهان، تعمیر است. قالب فصلی، بنر و تست A/B سلکتور را میشکند. اگر بودجه فقط برای اسکریپت اول است، رندر پایدار قول ندهید. گاهی API ناقص با سه فیلد، از مرورگر کامل با ده فیلد شکننده صادقانهتر است. برآورد را با ساعت رندر و ساعت نگهداری بنویسید، نه با «یک بار مینویسیم تمام».
اشتباهات رایج اسکرپ با Playwright
- روشنکردن مرورگر قبل از دیدن HTML خام
- چسبیدن به کلاس فشردهشده
- sleep ثابت بهجای انتظار عنصر
- موازیسازی تا حد اختلال منبع
- فرض اینکه ابزار تست مجوز برداشت میدهد
- نادیدهگرفتن robots و نوع داده
- تحویل بدون زمان برداشت و بدون گزارش شکست
چکلیست قبل از رندر مرورگر
- HTML خام و تب شبکه را با یک URL نمونه مقایسه کردهاید.
- API یا JSON داخل صفحه را رد نکردهاید.
- مسیرهای Disallow و دادهٔ شخصی از محدوده خارجاند.
- سلکتور به نقش یا متن پایدار وصل است.
- توقف خودکار وقتی تعداد کارت صفر است تعریف شده.
- تأخیر بین درخواستها با حجم واقعی میخواند.
- زمان برداشت و نسخهٔ انتخاب در خروجی هست.
- بودجهٔ نگهداری قالب در برآورد آمده است.
جمعبندی: رندر انتخابی، نه مرورگر برای همه
اسکرپ با Playwright یعنی خواندن DOM بعد از جاوااسکریپت، وقتی HTML کافی نیست. Scrapy زمانبند است؛ Selenium مسیر دیگر کنترل مرورگر است. سلکتور پایدار و هزینهٔ اجرا تصمیم را واقعی میکنند. رتبه، پوشش نامحدود و دورزدن قفل در کار نیست.
اگر میخواهید محدودهٔ رندر را روی منبع مجاز خودتان تعریف کنید، از صفحه اسکرپ داده روبینش و فرم مشاوره شروع کنید. این مقاله تعرفه نمیسازد. یک URL نمونه با دو مسیر — HTTP و مرورگر — این هفته، از روشنکردن کرومیوم برای تمام سایت مفیدتر است.
سؤالات متداول
برای هر اسکرپ باید Playwright روشن کنیم؟
خیر. اول HTML خام و درخواست شبکه را ببینید. اگر فیلد همانجا هست، مرورگر هزینهٔ اضافه است. رندر فقط وقتی DOM بعد از جاوااسکریپت منبع حقیقت است.
Playwright همان Scrapy است؟
خیر. Scrapy زمانبند و صف HTTP است. Playwright مرورگر را کنترل میکند. در پروژهٔ بالغ معمولاً هر دو نقش جدا دارند نه جایگزین هم.
سلکتور کلاس CSS کافی است؟
معمولاً نه. کلاس فشرده با بازطراحی میمیرد. به نقش، متن پایدار یا ساختار کارت بچسبید و اگر تعداد کارت صفر شد اجرا را متوقف کنید.
با Playwright میشود ورود و کپچا را دور زد؟
این مقاله آن مسیر را آموزش نمیدهد. اگر داده بدون شکستن قفل در دسترس نیست، منبع را حذف کنید یا خوراک رسمی بخواهید.
اسکرپ رندر را از کدام صفحه سفارش دهیم؟
مسیر اجرا در صفحه اسکرپ داده روبینش است. این مقاله زمان رندر را میگوید نه تعرفه را.